
 Chrome に追加
AI意思決定モデルとは?Jevがブラウザ自動化のコストを50倍安くする仕組み
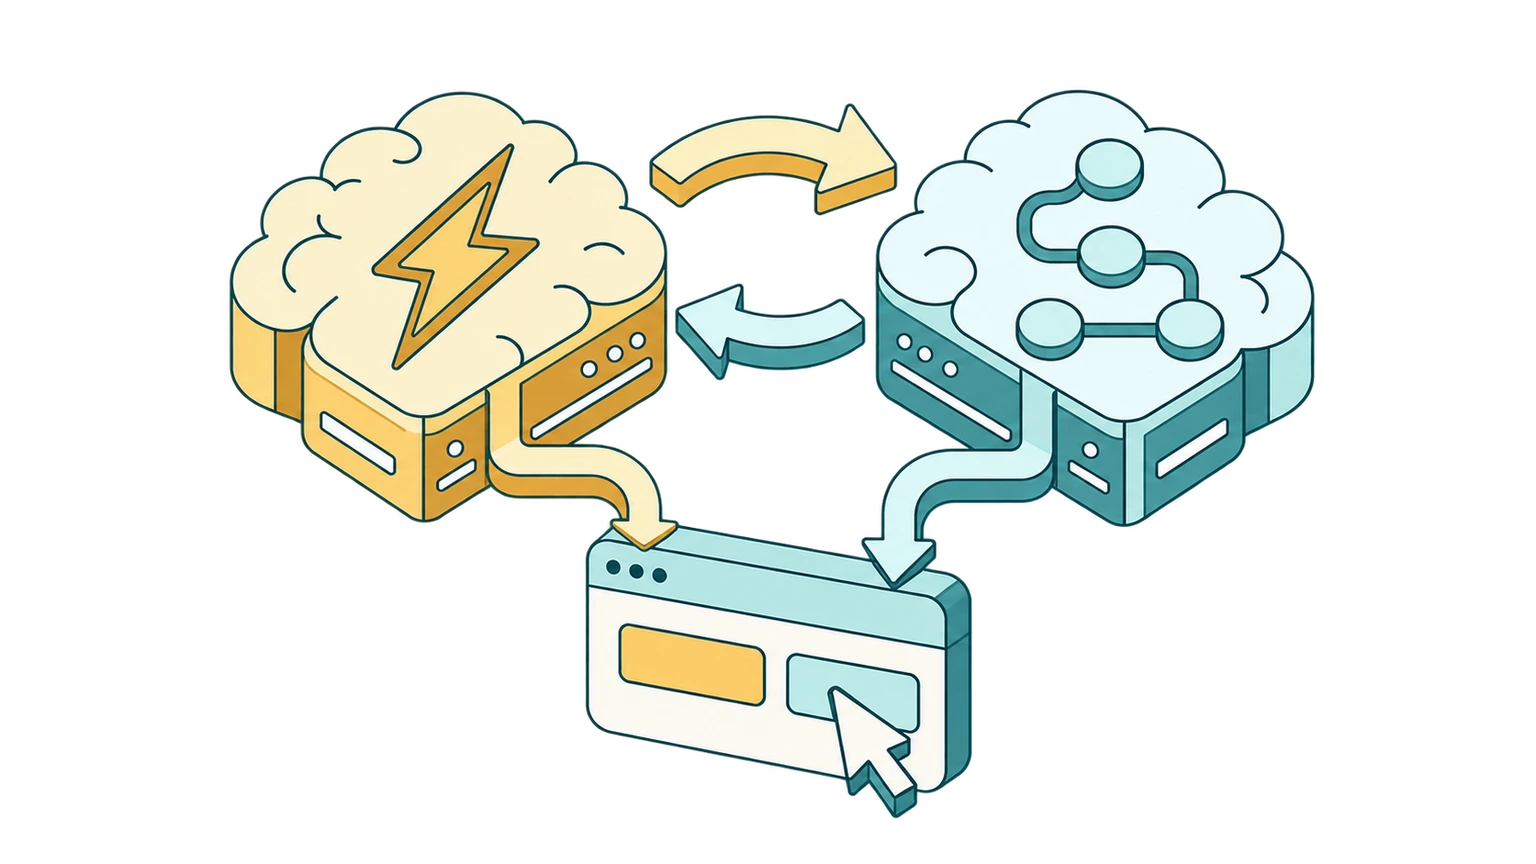
AIブラウザエージェントは、何かをクリックする前に「どこをクリックすべきか」を判断しなければなりません。そこでページの内容を言語モデルに送り、「次は何をすればいい?」と尋ねます。モデルはページ全体を読み込み、じっくり考え、答えを書いて返します。エージェントがクリックするのはそのあとです。
このやり取りで発生するトークンには、すべて料金がかかります。1回のクリックなら1セントにも満たない額です。でも、毎日実行する20ステップのタスクとなると、あっという間に積み上がっていきます。
しかも面白いことに、こうした質問のほとんどは簡単なものです。「このボタンのうち『カートに入れる』はどれ?」「フォームは送信できた?」「これはCookieバナー?」。人間なら深く考えるまでもなく、一瞬で答えられますよね。それなのに多くのAIエージェントは、毎回わざわざ本格的な言語モデルに回答を書かせるという、遅くて高くつくやり方でこれを処理しています。
こうした仕事にもっと向いた道具があります。それが AI意思決定モデル です。考え方自体は以前からありましたが、2026年9月にTypeSafe AIが Jev をリリースしたことで一気に注目を集めました。Jevは高速で、実行コストはほぼゼロ、そしてどんな質問にもほぼ対応できる意思決定モデルです。この記事では、意思決定モデルとは何か、ダニエル・カーネマンの『ファスト&スロー』がなぜそれを理解する最良の手がかりになるのか、そして「速い」モデルと「遅い」モデルで仕事を分担することで、すべてのステップをClaude Haikuのような小型LLMに任せる場合と比べて、ブラウザ自動化を 最大50倍安く できる理由を見ていきます。これはまさに、私たちがSurfMindのブラウザ操作に取り入れようとしている仕組みでもあります。
AI意思決定モデルとは?
AI意思決定モデル は、判断を下すモデルです。それだけです。文章は書きません。
あなたが状況(たとえばWebページ)と、答えの選択肢があらかじめ決まった質問を渡します。「この14個の要素のうち、購入手続きボタンはどれ?」「このページはログイン画面にブロックされている?」といった具合です。モデルは選択肢の中から1つを選び、その答えにどれくらい自信があるかを返します。長い文章も、説明も、あとから整形する手間もありません。
このシンプルさが、ソフトウェアに組み込むときに意外なほど役立ちます。理由は2つあります。
- 答えが必ず想定どおりの形になる。 渡した選択肢の中からしか選べないので、コード側はその結果をそのまま使って次の処理に進めます。
- 自分の確信度がわかっている。 優れた意思決定モデルは キャリブレーション(較正) されています。つまり「90%」と答えたときは、実際に約90%の確率で正解します。この確信度があるからこそ、エージェントはそのまま進むべきか、助けを求めるべきかを判断できます。
Jevはその好例です。文章は一切書かず、応答は1秒を大きく下回り、コストはLLMのほんの一部です。後ほど、公開されている料金をもとに、どれだけ節約できるかを計算してみます。
意思決定モデルは新しいものではない
判断だけを行う専用モデルという発想は、何年も前からさまざまな形で存在していました。
- ファインチューニングされた分類器:BERTベースのモデル(2018年〜)などは高速で正確ですが、1つのモデルが担えるのは1つの仕事だけです。スパムフィルターはスパムを検出する、それだけです。
- ゼロショット分類器:自然言語推論(NLI)モデルや、GLiClassのような新しいオープンモデルでは、質問するときにラベルを自由に決められ、学習も必要ありません。
- 報酬モデルと安全性分類器:MetaのLlama Guardのように、ほかのAIモデルの隣で動き、その出力を評価します。
- 分類器として使う小型LLM:返答を書く代わりに、各選択肢がどれくらい「ありそうか」だけを読み取ります。OpenJevなどのオープンプロジェクトはこの方式です。
では、なぜJevがここまで注目されたのでしょうか? Jevはこれらのアイデアを1つのホスト型モデルにまとめ、普通の言葉で書いたほぼどんな質問にも対応し、キャリブレーションされた確信度を返し、しかも1日に何百万回も行われる判断を前提にした価格設定になっています。第三者による比較では、オープンな代替モデルは自前で運用すればコストとプライバシーの面ですでに優位であるものの、初めて見るタイプの質問に対する精度ではまだJevに及ばない、という結果が出ています。この記事でJevを例として取り上げるのはそのためです。
意思決定モデルとLLMの違い
Claude、GPT、Geminiのような 大規模言語モデル(LLM) は、答えを1トークンずつ生成します。欲しいのが一言の答えだけでも、LLMはすべてを読み込み、回答を「書き」、しばしば理由まで説明してくれます。その全部に料金を払ったうえで、返答が指定したフォーマットになっていることを祈るしかありません。
| LLM | 意思決定モデル | |
|---|---|---|
| 出力 | 自由形式のテキスト | あなたが定義した選択肢から1つの答え |
| 文章を書いたり、段階的に推論したりできる? | できる | できない |
| 答えは常に指定のフォーマット? | たいていは。ただし常にではない | 常に |
| 確信度を教えてくれる? | 信頼できるほどではない | はい、キャリブレーションされた確率で |
| コスト | 入力トークンと出力トークンの両方に課金 | 通常は入力のみ、しかも価格はごく一部 |
| 速度 | 長い回答だと数秒 | 通常は1秒を大きく下回る |
| 得意なこと | 計画、文章作成、自由度の高い推論 | 高速で繰り返し行う、明確に定義された判断 |
どちらかがもう一方を置き換えるわけではありません。面白いのは2つを組み合わせたときで、そこで登場するのがカーネマンです。
『ファスト&スロー』:AIにおけるシステム1とシステム2
心理学者ダニエル・カーネマンは、2011年の著書『ファスト&スロー』で、人間の思考には2つのモードがあると説明しています。
- システム1 は速く、自動的で、努力を必要としません。友人の顔を見分ける、一時停止の標識を読む、2 + 2 = 4だとわかる。やろうと決めるまでもなく、自然にそうなります。
- システム2 は遅く、意図的で、努力を要します。旅行の計画を立てる、2つの住宅ローンを比較する、17 × 24を計算する。注意力とエネルギーを使うので、使いどころは限られます。
重要なのは、私たちが一日中やっていることの大半はシステム1だ という点です。システム2を呼び出すのは、何か新しいこと、難しいこと、意外なことに出くわしたときだけ。歩くときに一歩一歩を意識的に熟考していたら、どこにもたどり着けませんよね。
今のAIエージェントにはシステム2しかない
現在のAIエージェントのほとんどは、何から何まで大規模言語モデルに任せています。LLMがタスクを計画し、そのまま同じLLMがすべてのクリック、スクロール、キー入力を1つひとつ決めていきます。これは、プロジェクトの計画を立ててもらうためにシニアアナリストを雇ったのに、コピー取りまで全部本人にやらせているようなものです。
結果は目に見えています。遅くて、高くて、本来なら簡単なはずのステップで、不正な形式の応答のせいでときどき脱線してしまうエージェントの出来上がりです。
意思決定モデルがAIにシステム1を与える
意思決定モデルは、これまで欠けていたシステム1です。つまり、日常的な判断を速く、安く、自動的にこなし、手に負えないときは引き継ぐべきタイミングをわかっている判断レイヤーです。
2つを組み合わせると、その構成は人間の心とよく似たものになります。
- システム2(LLM) は、あなたの依頼を理解し、計画を立て、必要な文章を書き、想定外のことに対処します。
- システム1(意思決定モデル) は、計画を実行するために必要な、素早く繰り返される数多くの判断を担当します。
- 確信度が引き継ぎの合図になる。 意思決定モデルに自信があれば、エージェントはそのまま実行します。自信がなければ質問をLLMに回します。人間が「何かおかしいぞ」と感じたときに、慎重に考えるモードへ切り替えるのと同じです。
今のブラウザ自動化はなぜ高くつくのか
どこで節約できるのかを知るために、AIブラウザエージェントが各ステップで実際に何をしているかを見てみましょう。
- ページを読む。 エージェントはページの状態を取得します。簡略化したDOM、アクセシビリティツリー、あるいはスクリーンショットです。
- 判断する。 モデルはその状態に加えて、目標とそれまでのステップの履歴を読み込み、次のアクションを選びます。
- 実行する。 エージェントがクリック、入力、スクロールを行います。
- 確認する。 モデルが新しいページを見て、うまくいったかどうかを確認します。
そしてこれを繰り返します。コストがかかるのはステップ2です。ページの状態は大きく、1ステップあたり数千トークンになることも珍しくありません。さらに多くのエージェントは、どんどん長くなるタスクの履歴も毎ステップ送り直しています。業界の記事によれば、典型的なマルチステップのブラウザタスクは20,000〜60,000トークンに達し、しかもLLMは各アクションを書き出すための出力料金も払っています。
ここがポイントです。ページを候補要素のリストに変換してしまえば、そのステップのほとんどは 言語の問題ではありません。選択問題です。「この要素のうち、どれをクリックすべき?」「ページは期待どおりに変わった?」。これはまさにシステム1の仕事で、意思決定モデルが得意とするところです。
意思決定モデルがブラウザ操作のコストを最大50倍削減する仕組み
節約効果を具体的な数字で示すために、Jevと、大手AIラボのLLMの中でも特に手頃なClaude Haiku 4.5を比較してみます。TypeSafeはJevを「System One model」(システム1モデル)と呼んでおり、カーネマンの用語をそのまま使っています。
- Jev は 入力100万トークンあたり$0.042で、出力は無料 です(OpenRouterの場合)。応答は通常70〜500ミリ秒で返ってきます。
- Claude Haiku 4.5 は入力100万トークンあたり$1.00、出力100万トークンあたり$5.00です。
ブラウザタスクの中の、ごく日常的な1ステップを例に取りましょう。たとえば、クリックすべき正しい要素を選ぶ場面です。
このステップにLLM(Claude Haiku 4.5)を使う場合: エージェントは約12,000の入力トークン(指示、ツール定義、ページの状態、タスクの履歴)を送り、アクションを記述した約200の出力トークンを受け取ります。
- 入力:12,000 × $1.00 / 1M = $0.0120
- 出力:200 × $5.00 / 1M = $0.0010
- 合計:1ステップあたり約$0.013
同じステップに意思決定モデル(Jev)を使う場合: チャット履歴やツール定義は必要ありません。受け取るのはこのステップの目標と候補要素だけで、入力は約6,000トークン。返すのは選択肢1つと確信度で、出力は無料です。
- 入力:6,000 × $0.042 / 1M = $0.00025
- 出力:$0
- 合計:1ステップあたり約$0.00025
つまり、日常的なステップ1回あたり 約50分の1のコスト で済み、しかも答えは通常1秒もかからずに返ってきます。
タスク全体で見るとどうなるか
実際のタスクでは、どこかでシステム2が必要になります。LLMがあなたの依頼を理解して計画を立てなければなりませんし、本当に判断の難しいステップも出てきます。そのため、タスク全体での節約効果は何よりも1つの要素にかかっています。それは 意思決定モデルがどれくらいの頻度でステップをLLMに差し戻すか です。
上記の1ステップあたりの数字を使い、ハイブリッド構成ではHaikuによる計画呼び出しを1回(約$0.0075)含めた、20ステップのタスクで比べてみましょう。
| 構成 | 1タスクあたりのコスト | 1,000タスクあたりのコスト | LLMのみと比べた節約効果 |
|---|---|---|---|
| すべてのステップでLLM(Haiku)を使用 | $0.260 | $260 | 基準 |
| LLMが計画、意思決定モデルが判断、10%のステップを差し戻し | $0.039 | $39 | 約7倍安い |
| LLMが計画、意思決定モデルが判断、差し戻し0% | $0.013 | $13 | 約20倍安い |
| 意思決定モデルのみ(繰り返し実行する、または事前に計画済みのワークフロー) | $0.005 | $5 | 約50倍安い |
公開されている定価に基づく参考値です。実際の数字は、ページのサイズ、タスクに必要なステップ数、プロンプトキャッシュ、そしてタスクがLLMを必要とする頻度によって変わります。
傾向ははっきりしています。自動化の中に定型的な作業が多いほど、50倍に近づきます。 同じフォームへの入力、同じダッシュボードのチェック、同じ種類のページの仕分けなど、何度も繰り返し実行するワークフローこそ、意思決定モデルの本領が発揮される場面です。
第三者によるテストも同じ傾向を示しています。あるLiteLLMのルーティングテストでは、Jevの240回の呼び出しにかかったコストは$0.0077で、同じ呼び出しをClaude Haiku 4.5で行った場合の$0.1985と比べて約26倍安くなりました。
しかも速い
メリットはコストだけではありません。ある第三者ベンチマークでは、Jevの応答時間の中央値は239ミリ秒で、Claude Haiku 4.5の687ミリ秒と比べて約3倍高速でした。20ステップのタスク全体で見れば、ブラウザの前で待たされる時間が何秒も減ることになります。同じベンチマークでは、意思決定モデルの不正な形式の出力はゼロでした。与えられた選択肢の中からしか答えられないのですから、当然といえば当然です。
意思決定モデルの精度は十分なのか?
いくら安くても、クリックが正しくなければ意味がありません。正直なところを見ていきましょう。
意思決定モデルが最も得意なのは、範囲が狭く明確に定義された質問です。 公開されているフィッシング検出のベンチマークでは、Jevに「このメールはフィッシング?」という大まかな質問を1つだけ投げた場合、精度は62.6%で、Haikuの81.3%を下回りました。ところが同じタスクを5つの具体的な質問に分けると、意思決定モデルは 95.0% に達し、Haikuの93.2%を上回りました。
ここでもシステム1の教訓が当てはまります。速い思考は、シンプルで具体的な判断は得意ですが、複雑であいまいな判断は苦手です。だからこそ、正しい設計では仕事を分担します。
- タスクの分解はLLMに任せる。 小さく具体的な判断に切り分けます。
- 小さな判断の1つひとつには意思決定モデルが答える。 「どの要素?」「うまくいった?」といった判断です。
- 確信度をセーフティネットとして使う。 確信度の低い答えは、当て推量で進めずLLMに差し戻します。
Webページは信頼できない入力です。 Check Pointのセキュリティ研究者は、意思決定モデルもLLMと同じようにプロンプトインジェクションの標的になり得ることを示しています。答えの範囲が固定されていることで被害は限定されます(モデルはコードが与えた選択肢の中からしか選べません)が、リスクがなくなるわけではありません。SurfMindが人間の確認を必ず挟む理由の1つもここにあります。ブラウザ操作は、実行前に必ずあなたの許可を求めます。
SurfMindの意思決定モデル:ブラウザの中で「速い思考」と「遅い思考」を
SurfMindのブラウザ操作機能を使えば、普段使っているページの中で、AIがあなたの代わりにクリック、入力、スクロールを行います。これまでは、そのすべてのステップを言語モデルが処理していました。
私たちは、SurfMindのシステム1として意思決定モデルを導入します。まずはJevからです。
- あなたが選んだLLMがシステム2です。 依頼を理解し、タスクを計画し、必要な文章を書き、判断がはっきりしないときには前に出てきます。
- 意思決定モデルがシステム1です。 正しい要素を見つける、ステップが成功したかを確認する、ポップアップやバナーを見つけるといった、定型的で繰り返し発生する判断を担当します。
- 引き継ぎは確信度で決まります。 自信のある判断はそのまま実行し、不確かなものはフルモデルに回します。だから、信頼性を犠牲にせずにコストを節約できます。
- 主導権はあなたにあります。 ブラウザ操作は、これまでどおり実行前にあなたの許可を求めます。
目指すところはシンプルです。今使っているのと同じブラウザ自動化を、ずっと低いコストで。すべてのステップをClaude Haikuだけで処理する場合と比べて、最大50倍安く なる可能性があります。これは、SurfMindがこれまで大切にしてきた考え方とも一致します。すべてにプレミアム価格を払うのではなく、使った分だけ支払い、タスクに合ったモデルを選ぶというやり方です。
高額な請求を気にせず、ブラウザで使えるAIをお探しですか?
SurfMindは、300以上のAIモデルとブラウザ操作機能を、あなたが訪れるすべてのページに届けます。さらに意思決定モデルによって、定型的なクリックのコストが劇的に下がります。
関連記事
すべて表示
BYOKの意味とは?「Bring Your Own Key」とAIツールの未来
BYOKとは、自分のAPIキーをAIツールに接続して、サブスクではなく利用分だけ支払う仕組みです。40~90%節約し、5分で始める方法を解説します。
2026年版:無料で使えるOpenRouterモデルと、本当に役立つ使い方
OpenRouterにはNVIDIA、Google、OpenAIなどの無料モデルがあります。選ぶべきモデル、実際の制限、ブラウザでの使い方を紹介します。
月5ドル以下でClaude/GPTクオリティAIを手に入れる5つの方法
月20ドルのサブスクリプションをスキップ。Claude Sonnet 4.6、GPT-5.4、Gemini 3 Flashなどの最先端AIモデルに、BYOKと賢いモデル選択で手頃な価格でアクセスする方法を学びましょう。