
 Chrome에 추가
AI 의사결정 모델이란? Jev가 브라우저 자동화 비용을 50배 줄이는 방법
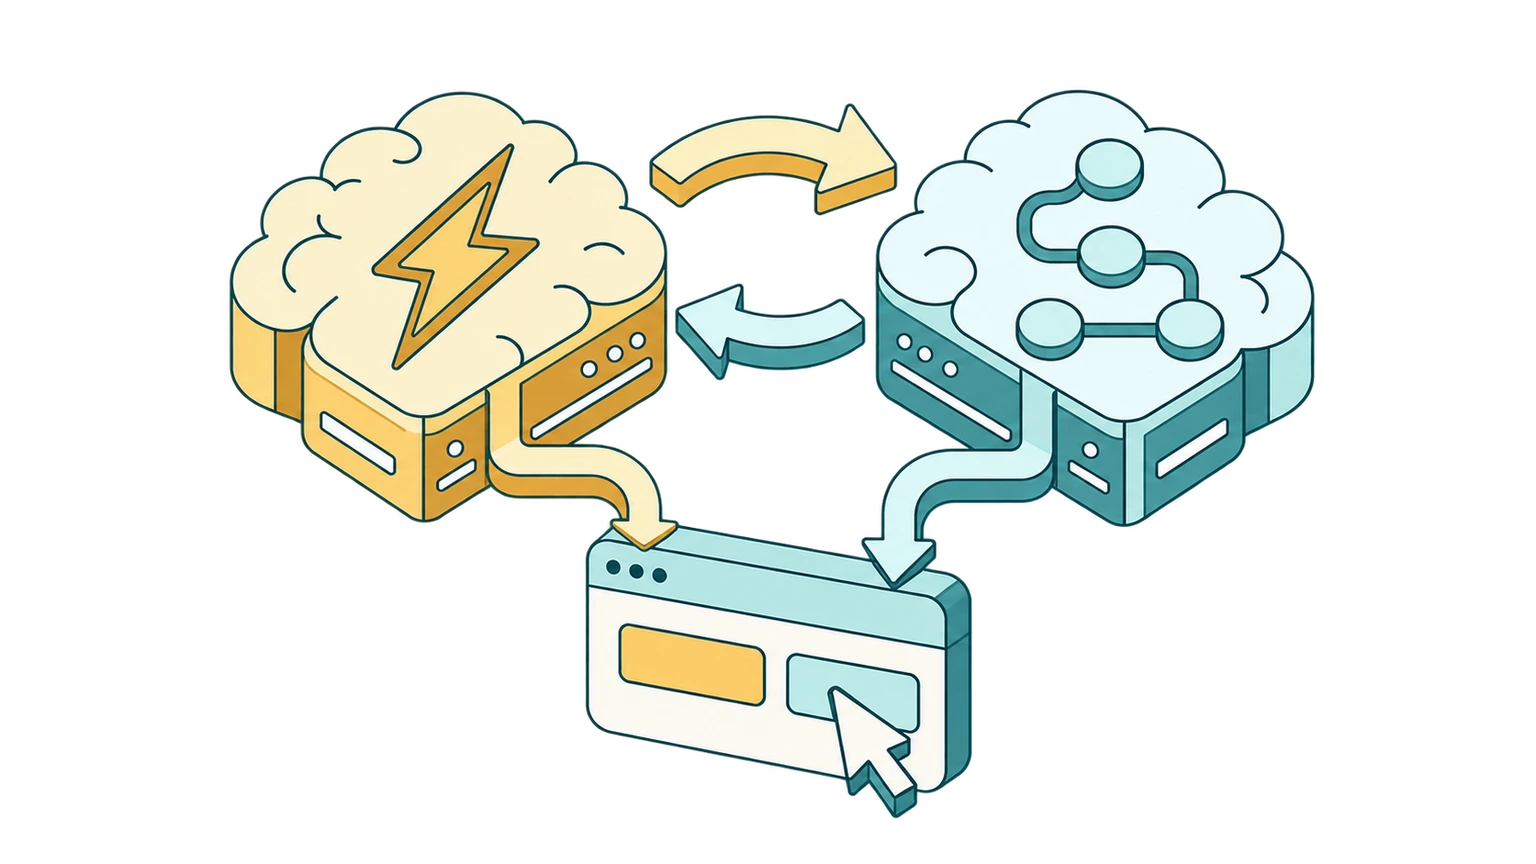
AI 브라우저 에이전트는 뭔가를 클릭하기 전에 먼저 무엇을 클릭할지 알아내야 해요. 그래서 페이지를 언어 모델에 보내고 "다음엔 뭘 해야 해?"라고 묻죠. 모델은 페이지 전체를 읽고, 곰곰이 생각한 다음, 답을 써서 돌려줍니다. 그제야 에이전트가 클릭을 해요.
이 왕복에 쓰인 토큰 하나하나가 전부 요금으로 청구됩니다. 클릭 한 번이면 1센트도 안 되는 돈이에요. 하지만 20단계짜리 작업을 매일 돌린다면? 금방 불어납니다.
그런데 재미있는 건, 이런 질문 대부분이 사실 쉽다는 거예요. "이 버튼들 중에 '장바구니 담기'는 어느 거지?" "폼이 제출됐나?" "이거 쿠키 배너인가?" 사람이라면 깊이 생각할 것도 없이 순식간에 답할 질문들이죠. 그런데도 대부분의 AI 에이전트는 매번 풀사이즈 언어 모델에게 답을 줄줄이 써 달라고 하는, 느리고 비싼 방식으로 이 질문들을 처리합니다.
이 일에는 더 알맞은 도구가 있어요. 바로 AI 의사결정 모델입니다. 개념 자체는 꽤 오래전부터 있었지만, 2026년 9월 TypeSafe AI가 Jev를 공개하면서 크게 주목받기 시작했어요. Jev는 빠르고, 운영 비용이 거의 들지 않으며, 어떤 질문을 던져도 대부분 척척 처리하는 의사결정 모델이에요. 이 글에서는 의사결정 모델이 무엇인지, 왜 대니얼 카너먼의 『생각에 관한 생각』이 이를 이해하는 가장 좋은 방법인지, 그리고 "빠른" 모델과 "느린" 모델에 일을 나눠 맡기면 모든 단계를 Claude Haiku 같은 소형 LLM으로 처리할 때보다 브라우저 자동화 비용을 어떻게 최대 50배까지 줄일 수 있는지 살펴볼게요. 그리고 이게 바로 저희가 SurfMind의 브라우저 액션에 도입하려는 기술이기도 해요.
AI 의사결정 모델이란?
AI 의사결정 모델은 결정을 내립니다. 그게 전부예요. 글은 쓰지 않아요.
상황(예를 들어 웹 페이지 하나)과 함께, 정해진 선택지가 있는 질문을 건네면 됩니다. "이 14개 요소 중 결제 버튼은 어느 것인가?" 또는 "로그인 화면이 이 페이지를 가로막고 있는가?" 같은 식으로요. 모델은 주어진 답 중 하나를 고르고, 그 답을 얼마나 확신하는지 알려줍니다. 장황한 문단도, 설명도, 나중에 정리할 군더더기도 없어요.
그래서 소프트웨어 안에서 의외로 쓸모가 많은데, 이유는 두 가지예요.
- 답이 항상 형식에 맞아요. 내가 준 선택지 중에서만 고를 수 있으니, 코드가 결과를 받자마자 바로 처리할 수 있어요.
- 자기가 얼마나 확신하는지 알아요. 좋은 의사결정 모델은 보정(calibration)이 잘 되어 있어요. 90%라고 말하면 실제로 약 90%의 확률로 맞는다는 뜻이죠. 이 확신도 덕분에 에이전트는 언제 그냥 진행하고 언제 도움을 요청해야 할지 판단할 수 있어요.
Jev가 좋은 예예요. 단어 하나 쓰지 않고, 1초도 한참 안 걸려 답하며, 비용은 LLM의 극히 일부에 불과해요. 뒤에서 Jev의 공개 가격으로 절감액을 직접 계산해 볼게요.
의사결정 모델은 새로운 개념이 아니에요
판단만 전담하는 별도의 모델이라는 아이디어는 몇 가지 형태로 오래전부터 존재해 왔어요.
- 파인튜닝된 분류기: BERT 기반 모델(2018년~) 같은 것들은 빠르고 정확하지만, 각각 한 가지 일밖에 몰라요. 스팸 필터는 스팸을 걸러낼 뿐, 그 이상은 못 하죠.
- 제로샷 분류기: 자연어 추론(NLI) 모델이나 GLiClass 같은 최신 오픈 모델은 따로 학습시킬 필요 없이 질문할 때 레이블을 마음대로 정할 수 있어요.
- 보상 모델과 안전 분류기: Meta의 Llama Guard처럼 다른 AI 모델 옆에서 그 출력물을 평가해요.
- 분류기로 쓰는 소형 LLM: 답변을 작성하는 대신 각 선택지의 확률만 읽어내요. OpenJev 같은 오픈 프로젝트가 이런 방식으로 동작하죠.
그렇다면 Jev는 왜 이렇게 떴을까요? 이 아이디어들을 하나의 호스팅 모델로 묶어서, 쉬운 영어로 설명한 거의 모든 질문을 처리하고, 보정된 확신도를 제공하며, 하루에 수백만 번 일어나는 결정에 맞춘 가격을 책정했기 때문이에요. 독립적인 비교 분석에 따르면, 오픈 대안들은 직접 운영할 경우 비용과 프라이버시 면에서는 이미 앞서지만, 처음 보는 유형의 질문에서는 정확도가 여전히 Jev에 못 미쳐요. 그래서 이 글에서는 Jev를 예시로 계속 사용할게요.
의사결정 모델 vs. LLM
Claude, GPT, Gemini 같은 대규모 언어 모델(LLM)은 토큰을 하나씩 생성하면서 답을 만들어요. 한 단어짜리 답만 원할 때도 LLM은 모든 걸 읽고, 답을 "써 내려가고", 종종 부연 설명까지 덧붙여요. 그 전부에 돈을 내고 나서, 답이 요청한 형식대로 왔기만을 바라야 하죠.
| LLM | 의사결정 모델 | |
|---|---|---|
| 출력 | 자유 형식 텍스트 | 내가 정한 선택지 중 하나 |
| 글쓰기나 단계별 추론이 가능한가? | 예 | 아니요 |
| 답이 항상 내 형식에 맞는가? | 대체로 그렇지만 항상은 아님 | 항상 |
| 확신도를 알려주는가? | 신뢰하기 어려움 | 예, 보정된 확률로 |
| 비용 | 입력·출력 토큰 모두 과금 | 보통 입력만 과금, 가격도 훨씬 저렴 |
| 속도 | 긴 답변은 수 초 | 보통 1초도 한참 안 걸림 |
| 강점 | 계획, 글쓰기, 열린 추론 | 빠르고 반복적이며 명확한 판단 |
어느 한쪽이 다른 쪽을 대체하는 게 아니에요. 흥미로운 건 둘을 합쳤을 때 벌어지는 일이고, 여기서 카너먼이 등장합니다.
생각에 관한 생각: AI를 위한 시스템 1과 시스템 2
심리학자 대니얼 카너먼은 2011년 저서 『생각에 관한 생각』에서 인간 사고의 두 가지 방식을 설명해요.
- 시스템 1은 빠르고, 자동적이며, 힘이 들지 않아요. 친구 얼굴을 알아보고, 정지 표지판을 읽고, 2 + 2 = 4라는 걸 아는 것처럼요. 하겠다고 마음먹는 게 아니라 그냥 저절로 일어나죠.
- 시스템 2는 느리고, 신중하며, 노력이 필요해요. 여행 계획을 짜고, 주택담보대출 조건 두 개를 비교하고, 17 × 24를 계산하는 것처럼요. 주의력과 에너지가 드니까 아껴서 쓰게 돼요.
핵심 통찰은 우리가 하루 종일 하는 일의 대부분이 시스템 1이라는 거예요. 새롭거나, 어렵거나, 예상 밖의 일이 생길 때만 시스템 2를 불러내죠. 걸을 때마다 한 걸음 한 걸음을 의식적으로 고민해야 한다면, 어디에도 도착하지 못할 거예요.
오늘날의 AI 에이전트에는 시스템 2밖에 없어요
지금 대부분의 AI 에이전트는 모든 일에 대규모 언어 모델을 사용해요. LLM이 작업 계획을 세우고, 그다음엔 같은 LLM이 클릭, 스크롤, 키 입력 하나하나를 전부 결정하죠. 시니어 분석가를 고용해 프로젝트 계획을 맡기고는, 복사까지 전부 직접 하라고 시키는 격이에요.
결과는 뻔해요. 느리고, 비싸고, 사소해야 할 단계에서 형식이 어긋난 응답 하나 때문에 가끔 궤도를 이탈하는 에이전트가 되죠.
의사결정 모델이 AI에 시스템 1을 선물해요
의사결정 모델은 그동안 빠져 있던 시스템 1이에요. 일상적인 판단은 빠르고 저렴하게 자동으로 처리하고, 언제 넘겨야 할지도 아는 판단 계층이죠.
둘을 합치면 구조가 사람의 마음과 꽤 비슷해져요.
- 시스템 2(LLM)는 요청을 이해하고, 계획을 세우고, 필요한 글을 쓰고, 이례적인 상황을 처리해요.
- 시스템 1(의사결정 모델)은 계획을 실행하는 데 필요한 수많은 빠르고 반복적인 결정을 내려요.
- 확신도가 바통을 넘기는 신호예요. 의사결정 모델이 확신하면 에이전트는 바로 실행해요. 확신이 없으면 질문을 LLM으로 넘기죠. 뭔가 이상하다 싶을 때 사람이 신중한 사고 모드로 전환하는 것처럼요.
지금의 브라우저 자동화는 왜 비쌀까?
절감 효과가 어디서 오는지 보려면, AI 브라우저 에이전트가 단계마다 실제로 무슨 일을 하는지 살펴봐야 해요.
- 페이지 읽기. 에이전트가 페이지 상태를 캡처해요. 단순화한 DOM, 접근성 트리, 또는 스크린샷 형태로요.
- 결정하기. 모델이 그 상태와 함께 목표, 이전 단계의 기록을 읽고 다음 행동을 골라요.
- 실행하기. 에이전트가 클릭하거나, 입력하거나, 스크롤해요.
- 확인하기. 모델이 새 페이지를 보고 제대로 됐는지 확인해요.
그리고 이걸 반복하죠. 비용이 많이 드는 건 2단계예요. 페이지 상태는 용량이 커서 단계마다 수천 토큰에 달하는 경우가 많고, 많은 에이전트가 점점 길어지는 작업 기록까지 매 단계 다시 보내요. 업계 분석에 따르면 일반적인 다단계 브라우저 작업은 20,000~60,000 토큰을 쓰고, LLM은 각 행동을 써 내려가는 데 출력 요금까지 물어요.
그런데 여기서 포인트가 있어요. 페이지를 후보 요소 목록으로 바꿔 놓고 나면, 이 단계들 대부분은 언어 문제가 아니에요. 객관식 문제죠. "이 요소들 중 어느 걸 클릭해야 하지?" "페이지가 예상대로 바뀌었나?" 이건 시스템 1의 일이고, 의사결정 모델이 딱 이런 일을 위해 만들어졌어요.
의사결정 모델로 브라우저 액션 비용을 최대 50배 줄이는 방법
절감 효과를 실제 숫자로 보여드리기 위해 Jev를 주요 AI 연구소의 LLM 중 가장 저렴한 축에 속하는 Claude Haiku 4.5와 비교해 볼게요. TypeSafe는 카너먼의 용어를 그대로 가져와 Jev를 "System One model"(시스템 1 모델)이라고 불러요.
- Jev는 입력 토큰 100만 개당 $0.042이고, 출력은 무료예요(OpenRouter 기준). 답은 보통 70~500밀리초 안에 도착해요.
- Claude Haiku 4.5는 입력 토큰 100만 개당 $1.00, 출력 토큰 100만 개당 $5.00이에요.
브라우저 작업의 평범한 한 단계, 예를 들어 클릭할 요소를 고르는 단계를 하나 떼어 볼게요.
LLM(Claude Haiku 4.5)으로 이 단계를 처리하면: 에이전트는 약 12,000개의 입력 토큰(지시문, 도구 정의, 페이지 상태, 작업 기록)을 보내고, 행동을 설명하는 약 200개의 출력 토큰을 돌려받아요.
- 입력: 12,000 × $1.00 / 1M = $0.0120
- 출력: 200 × $5.00 / 1M = $0.0010
- 합계: 단계당 약 $0.013
의사결정 모델(Jev)로 같은 단계를 처리하면: 대화 기록이나 도구 정의가 필요 없어요. 이번 단계의 목표와 후보 요소들, 약 6,000개의 입력 토큰만 받고, 선택지 하나와 확신도를 돌려줘요. 출력은 무료예요.
- 입력: 6,000 × $0.042 / 1M = $0.00025
- 출력: $0
- 합계: 단계당 약 $0.00025
일상적인 단계 하나당 약 50배 저렴한 셈이고, 답도 보통 1초도 한참 안 걸려 돌아와요.
작업 전체로 보면 어떨까요?
실제 작업에는 어딘가에서 여전히 시스템 2가 필요해요. LLM이 요청을 이해하고 계획을 세워야 하고, 정말로 애매한 단계도 있기 마련이니까요. 그래서 작업 전체의 절감 효과는 무엇보다 한 가지에 달려 있어요. 바로 의사결정 모델이 얼마나 자주 LLM에게 단계를 되넘기느냐예요.
위의 단계별 수치를 바탕으로, 하이브리드 구성에서는 Haiku 계획 호출(~$0.0075)을 한 번 포함해 20단계 작업을 계산해 보면 이래요.
| 구성 | 작업당 비용 | 작업 1,000건 비용 | LLM 단독 대비 절감 |
|---|---|---|---|
| 모든 단계를 LLM(Haiku)으로 처리 | $0.260 | $260 | 기준 |
| LLM이 계획, 의사결정 모델이 결정, 10% 단계 에스컬레이션 | $0.039 | $39 | 약 7배 저렴 |
| LLM이 계획, 의사결정 모델이 결정, 에스컬레이션 0% | $0.013 | $13 | 약 20배 저렴 |
| 반복되거나 미리 계획된 워크플로에서 의사결정 모델만 사용 | $0.005 | $5 | 약 50배 저렴 |
공개 정가를 바탕으로 한 예시 추정치예요. 실제 수치는 페이지 크기, 작업의 단계 수, 프롬프트 캐싱, 그리고 작업이 LLM을 얼마나 자주 필요로 하는지에 따라 달라져요.
패턴은 분명해요. 자동화 중 일상적인 부분이 많을수록 50배 쪽에 가까워져요. 같은 폼을 채우거나, 같은 대시보드를 확인하거나, 같은 유형의 페이지를 분류하는 것처럼 반복해서 돌리는 워크플로야말로 의사결정 모델이 빛을 발하는 곳이에요.
독립 테스트 결과도 같은 방향을 가리켜요. 한 LiteLLM 라우팅 테스트에서는 Jev 호출 240건의 비용이 $0.0077이었는데, 같은 호출을 Claude Haiku 4.5로 처리하면 $0.1985가 들었어요. 약 26배 저렴한 거죠.
속도도 더 빨라요
이점은 비용만이 아니에요. 한 독립 벤치마크에서 Jev의 응답 시간 중앙값은 239ms로, Claude Haiku 4.5의 687ms보다 약 3배 빨랐어요. 20단계 작업이라면 브라우저 앞에서 기다리는 시간이 몇 초씩 줄어드는 거예요. 같은 벤치마크에서 의사결정 모델의 형식 오류 출력은 0건이었어요. 주어진 선택지 중 하나로만 답할 수 있으니까요.
의사결정 모델, 정확도는 충분할까?
싸다는 건 클릭이 정확할 때나 의미가 있죠. 솔직하게 말씀드릴게요.
의사결정 모델은 좁고 명확한 질문에 가장 강해요. 공개된 피싱 탐지 벤치마크에서 Jev에게 광범위한 질문 하나("이 이메일은 피싱인가?")를 던졌더니 정확도가 62.6%로, Haiku의 81.3%에 못 미쳤어요. 하지만 같은 작업을 좁은 질문 다섯 개로 쪼갰더니 의사결정 모델이 95.0%의 정확도를 기록하며 Haiku의 93.2%를 앞질렀어요.
다시 한번 시스템 1의 교훈이에요. 빠른 사고는 단순하고 구체적인 판단에는 뛰어나지만, 복잡하고 모호한 판단에는 약해요. 그러니 올바른 설계는 일을 나누는 거예요.
- 작업 분해는 LLM에게 맡기세요. 작고 구체적인 결정들로 쪼개는 거죠.
- 작은 결정 하나하나는 의사결정 모델이 답하게 하세요. "어떤 요소?"나 "제대로 됐나?" 같은 것들요.
- 확신도를 안전망으로 쓰세요. 확신도가 낮은 답은 찍지 않고 LLM으로 되돌려 보내요.
웹 페이지는 신뢰할 수 없는 입력이에요. Check Point의 보안 연구진은 의사결정 모델도 LLM과 마찬가지로 프롬프트 인젝션의 표적이 될 수 있다는 걸 보여줬어요. 답의 범위가 고정되어 있으니 피해는 제한되지만(모델은 코드가 준 선택지 중에서만 고를 수 있으니까요), 위험이 사라지는 건 아니에요. SurfMind가 사람이 반드시 개입하도록 하는 이유가 하나 더 생긴 셈이죠. 브라우저 액션은 실행 전에 항상 사용자의 허락을 구해요.
SurfMind의 의사결정 모델: 브라우저 안의 빠른 사고와 느린 사고
SurfMind의 브라우저 액션을 쓰면 지금 사용 중인 페이지 안에서 AI가 대신 클릭하고, 입력하고, 스크롤해요. 지금까지는 이 모든 단계가 언어 모델을 거쳤어요.
이제 SurfMind의 시스템 1로 의사결정 모델을 추가합니다. 그 시작은 Jev예요.
- 내가 고른 LLM이 시스템 2예요. 요청을 이해하고, 작업을 계획하고, 필요한 글을 쓰고, 애매한 상황이 생기면 언제든 나서요.
- 의사결정 모델이 시스템 1이에요. 올바른 요소 찾기, 단계가 잘 됐는지 확인하기, 팝업과 배너 알아채기 같은 일상적이고 반복적인 결정을 처리해요.
- 확신도가 바통 터치를 결정해요. 확신 있는 결정은 그대로 진행되고, 불확실한 결정은 풀 모델로 넘어가요. 그래서 신뢰성을 포기하지 않고도 비용을 아낄 수 있어요.
- 주도권은 여전히 사용자에게 있어요. 브라우저 액션은 지금처럼 실행 전에 허락을 구해요.
목표는 단순해요. 지금 쓰는 브라우저 자동화를 그대로, 비용은 훨씬 적게. 잘하면 모든 단계를 Claude Haiku로만 처리할 때보다 최대 50배 저렴하게요. 이건 SurfMind가 늘 지켜 온 방식과도 맞닿아 있어요. 쓴 만큼만 내고, 모든 일에 프리미엄 요금을 내는 대신 작업에 맞는 모델을 고르는 것이죠.
요금 폭탄 없이 브라우저에서 일하는 AI를 원하시나요?
SurfMind는 방문하는 모든 페이지에 300개 이상의 AI 모델과 브라우저 액션을 제공해요. 여기에 의사결정 모델까지 더해져, 일상적인 클릭 비용이 확 줄어들어요.
관련 게시물
모두 보기
BYOK 뜻: Bring Your Own Key란 무엇이며 왜 AI 도구의 미래인가
BYOK는 개인 API 키를 AI 도구에 연결해 구독료 대신 사용량만 결제하는 방식입니다. 비용을 40~90% 절약하고 5분 만에 시작하는 방법을 알아보세요.
2026년 최고의 무료 OpenRouter 모델(그리고 제대로 활용하는 법)
OpenRouter는 NVIDIA, Google, OpenAI 등의 무료 모델을 제공합니다. 쓸 만한 모델, 실제 제한, 브라우저에서 활용하는 방법을 알아보세요.
월 5달러 미만으로 Claude·GPT급 AI 쓰는 5가지 방법
월 20달러 구독, 꼭 필요할까요? BYOK와 똑똑한 모델 선택으로 Claude Sonnet 4.6, GPT-5.4, Gemini 3 Flash 같은 최상급 모델을 훨씬 저렴하게 쓰는 방법을 소개합니다.