
 Zu Chrome hinzufügen
Was ist ein KI-Entscheidungsmodell? So macht Jev Browser-Automatisierung 50-mal günstiger
Bevor ein KI-Browser-Agent irgendwo klickt, muss er erst mal herausfinden, wohin. Also schickt er die Seite an ein Sprachmodell und fragt: „Was soll ich als Nächstes tun?“ Das Modell liest die komplette Seite, denkt nach und schreibt eine Antwort zurück. Dann klickt der Agent.
Für jedes Token dieser Runde zahlst du. Für einen einzelnen Klick ist das ein Bruchteil eines Cents. Bei einer Aufgabe mit 20 Schritten, die du jeden Tag laufen lässt, läppert sich das schnell.
Und jetzt kommt der Witz: Die meisten dieser Fragen sind simpel. „Welcher dieser Buttons ist ‚In den Warenkorb‘?“ „Wurde das Formular abgeschickt?“ „Ist das ein Cookie-Banner?“ Du würdest sie in einem Sekundenbruchteil beantworten, ohne groß nachzudenken. Trotzdem beantworten die meisten KI-Agenten sie auf die langsame, teure Tour: Jedes Mal muss ein vollwertiges Sprachmodell eine komplette Antwort ausformulieren.
Für diesen Job gibt es ein besseres Werkzeug: das KI-Entscheidungsmodell. Die Idee gibt es schon eine Weile, aber im September 2026 bekam sie deutlich mehr Aufmerksamkeit, als TypeSafe AI Jev veröffentlicht hat – ein Entscheidungsmodell, das schnell ist, im Betrieb so gut wie nichts kostet und mit fast jeder Frage klarkommt, die du ihm stellst. In diesem Artikel schauen wir uns an, was Entscheidungsmodelle sind, warum Daniel Kahnemans Schnelles Denken, langsames Denken der beste Weg ist, sie zu verstehen, und wie du Browser-Automatisierung bis zu 50-mal günstiger machst, wenn du die Arbeit zwischen „schnellen“ und „langsamen“ Modellen aufteilst, statt jeden Schritt durch ein kleines LLM wie Claude Haiku zu jagen. Genau das bringen wir auch in die Browser-Aktionen von SurfMind.
Was ist ein KI-Entscheidungsmodell?
Ein KI-Entscheidungsmodell trifft Entscheidungen. Punkt. Es schreibt nicht.
Du gibst ihm eine Situation (zum Beispiel eine Webseite) und eine Frage mit festen Antwortmöglichkeiten: „Welches dieser 14 Elemente ist der Checkout-Button?“ oder „Blockiert eine Login-Sperre diese Seite?“ Es wählt eine deiner Antworten aus und sagt dir, wie sicher es sich ist. Keine Absätze, keine Erklärungen, nichts, was du hinterher aufräumen musst.
Genau das macht es in Software überraschend nützlich, und zwar aus zwei Gründen:
- Die Antwort passt immer. Es kann nur aus den Optionen wählen, die du vorgegeben hast, also kann dein Code direkt mit dem Ergebnis weiterarbeiten.
- Es weiß, wie sicher es ist. Ein gutes Entscheidungsmodell ist kalibriert: Wenn es 90 % sagt, liegt es in etwa 90 % der Fälle richtig. An dieser Konfidenz erkennt der Agent, wann er einfach loslegen kann und wann er Hilfe holen sollte.
Jev ist ein gutes Beispiel dafür. Es schreibt kein einziges Wort, antwortet in deutlich unter einer Sekunde und kostet nur einen Bruchteil dessen, was ein LLM kostet. Mit seinen veröffentlichten Preisen rechnen wir später die Ersparnis aus.
Entscheidungsmodelle sind nichts Neues
Die Idee eines separaten Modells, das nur urteilt, gibt es schon seit Jahren, in verschiedenen Varianten:
- Feinabgestimmte Klassifikatoren wie BERT-basierte Modelle (seit 2018) sind schnell und präzise, aber jeder kann nur genau eine Sache. Ein Spamfilter erkennt Spam, und das war’s.
- Zero-Shot-Klassifikatoren, etwa Modelle für Natural Language Inference (NLI) und neuere offene Modelle wie GLiClass, lassen dich die Labels direkt beim Fragen festlegen, ganz ohne Training.
- Reward-Modelle und Sicherheitsklassifikatoren wie Llama Guard von Meta laufen neben anderen KI-Modellen und bewerten, was diese erzeugen.
- Kleine LLMs als Klassifikatoren sparen sich die ausformulierte Antwort und lesen einfach ab, wie wahrscheinlich jede Antwortoption ist. Offene Projekte wie OpenJev funktionieren so.
Warum ist Jev dann so durchgestartet? Es bündelt all diese Ideen in einem gehosteten Modell, das mit fast jeder Frage klarkommt, die du in normaler Sprache beschreibst, dir eine kalibrierte Konfidenz liefert und preislich auf Entscheidungen ausgelegt ist, die millionenfach am Tag fallen. Unabhängige Vergleiche zeigen: Offene Alternativen gewinnen bei Kosten und Datenschutz schon jetzt, wenn du sie selbst betreibst, liegen bei unbekannten Fragen in der Genauigkeit aber noch hinter Jev. Deshalb nehmen wir Jev in diesem Artikel durchgehend als Beispiel.
Entscheidungsmodelle vs. LLMs
Ein Large Language Model (LLM) wie Claude, GPT oder Gemini erzeugt seine Antwort Token für Token. Selbst wenn du nur eine Antwort aus einem Wort willst, liest das LLM alles, „schreibt“ seine Antwort und erklärt sich oft noch dazu. Du bezahlst für alles davon und hoffst dann, dass die Antwort auch in dem Format kommt, das du angefordert hast.
| LLM | Entscheidungsmodell | |
|---|---|---|
| Ausgabe | Freier Text | Eine Antwort aus den von dir festgelegten Optionen |
| Kann es schreiben oder Schritt für Schritt schlussfolgern? | Ja | Nein |
| Antwort immer in deinem Format? | Meistens, aber nicht immer | Immer |
| Sagt es dir, wie sicher es ist? | Nicht zuverlässig | Ja, als kalibrierte Wahrscheinlichkeit |
| Kosten | Input- und Output-Tokens werden berechnet | Meist nur Input, zu einem Bruchteil des Preises |
| Geschwindigkeit | Sekunden bei längeren Antworten | Meist deutlich unter einer Sekunde |
| Am besten für | Planen, Schreiben, offenes Schlussfolgern | Schnelle, wiederkehrende, klar definierte Urteile |
Keins ersetzt das andere. Spannend wird es, wenn du beide kombinierst – und genau da kommt Kahneman ins Spiel.
Schnelles Denken, langsames Denken: System 1 und System 2 für KI
In seinem Buch Schnelles Denken, langsames Denken von 2011 beschreibt der Psychologe Daniel Kahneman zwei Arten, wie Menschen denken:
- System 1 ist schnell, automatisch und mühelos. Das Gesicht eines Freundes erkennen, ein Stoppschild lesen, wissen, dass 2 + 2 = 4 ist. Du entscheidest dich nicht bewusst dafür, es passiert einfach.
- System 2 ist langsam, bewusst und anstrengend. Eine Reise planen, zwei Kreditangebote vergleichen, 17 × 24 ausrechnen. Das kostet Aufmerksamkeit und Energie, also setzt du es sparsam ein.
Die entscheidende Erkenntnis: Das meiste, was wir den ganzen Tag tun, ist System 1. System 2 holen wir nur dazu, wenn etwas neu, schwierig oder überraschend ist. Müsstest du beim Gehen über jeden einzelnen Schritt bewusst nachdenken, kämst du nirgendwo an.
Heutige KI-Agenten haben nur System 2
Die meisten KI-Agenten nutzen heute für alles ein großes Sprachmodell. Das LLM plant die Aufgabe, und dann entscheidet dasselbe LLM über jeden einzelnen Klick, jeden Scroll und jeden Tastendruck. Das ist, als würdest du eine Senior-Analystin einstellen, damit sie ein Projekt plant, und sie dann auch noch jede Kopie persönlich machen lassen.
Das Ergebnis ist absehbar: Agenten, die langsam und teuer sind und gelegentlich an einer kaputten Antwort scheitern – ausgerechnet bei einem Schritt, der eigentlich trivial hätte sein sollen.
Entscheidungsmodelle geben KI ein System 1
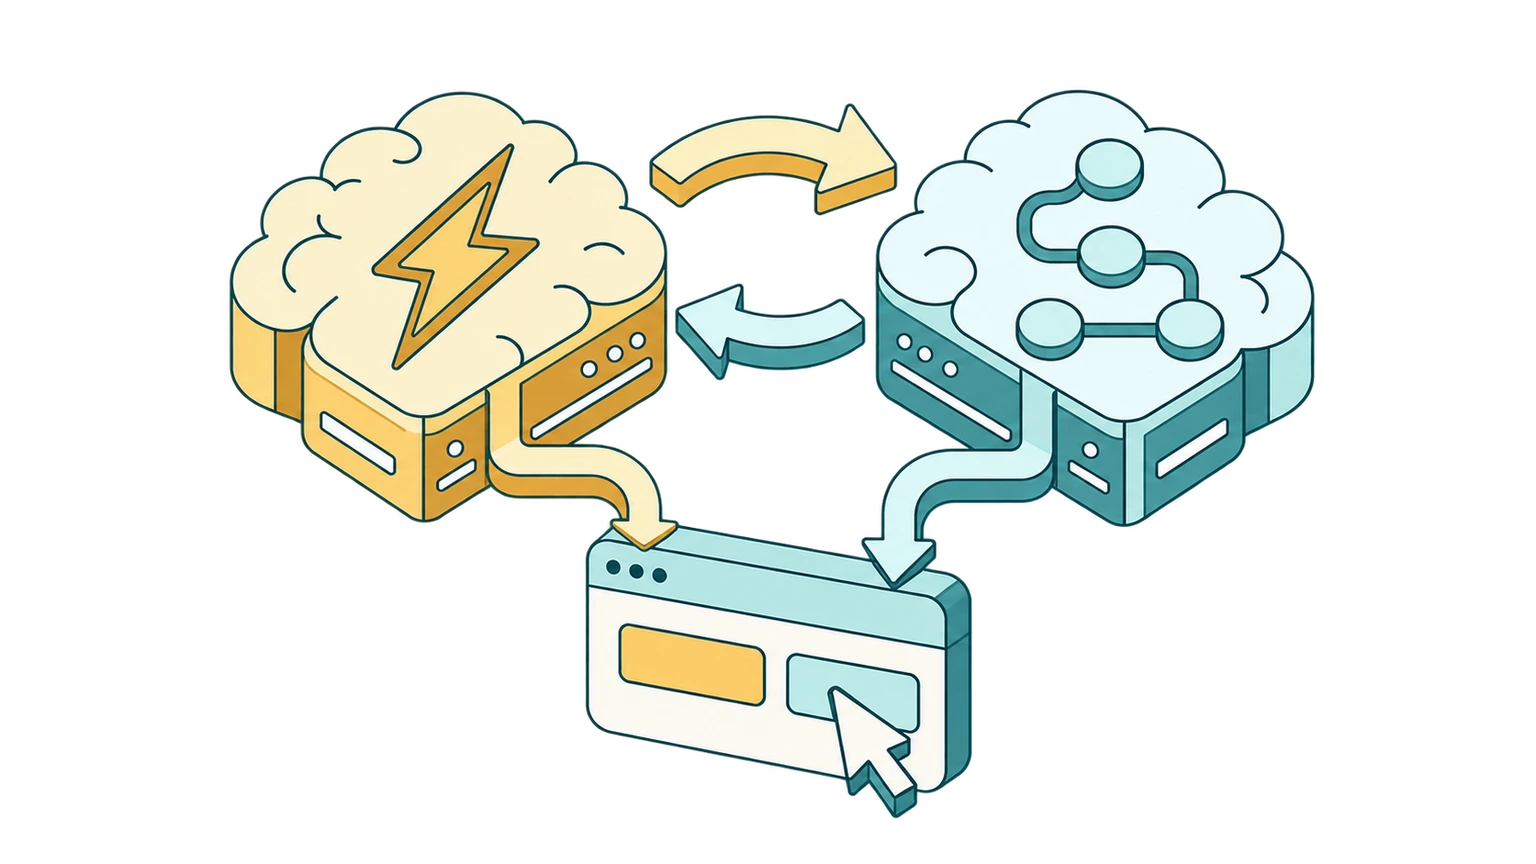
Ein Entscheidungsmodell ist das fehlende System 1: eine schnelle, günstige, automatische Urteilsebene, die die Routineentscheidungen übernimmt und weiß, wann sie abgeben muss.
Setzt du beides zusammen, sieht die Architektur dem menschlichen Denken ziemlich ähnlich:
- System 2 (das LLM) versteht, was du willst, macht den Plan, schreibt Texte und kümmert sich um alles Ungewöhnliche.
- System 1 (das Entscheidungsmodell) trifft die vielen schnellen, sich wiederholenden Entscheidungen, die es braucht, um den Plan umzusetzen.
- Die Konfidenz ist das Übergabesignal. Ist sich das Entscheidungsmodell sicher, handelt der Agent. Wenn nicht, geht die Frage ans LLM – genau wie du auf gründliches Nachdenken umschaltest, wenn sich etwas komisch anfühlt.
Warum Browser-Automatisierung heute so teuer ist
Um zu sehen, wo die Ersparnis herkommt, schau dir an, was ein KI-Browser-Agent bei jedem Schritt tatsächlich macht:
- Seite lesen. Der Agent erfasst den Zustand der Seite: ein vereinfachtes DOM, einen Accessibility Tree oder einen Screenshot.
- Entscheiden. Das Modell liest diesen Zustand plus das Ziel und den bisherigen Verlauf und wählt die nächste Aktion.
- Handeln. Der Agent klickt, tippt oder scrollt.
- Prüfen. Das Modell schaut sich die neue Seite an, um zu sehen, ob es geklappt hat.
Und dann das Ganze von vorn. Der teure Teil ist Schritt 2. Der Seitenzustand ist groß, oft Tausende Tokens pro Schritt, und viele Agenten schicken bei jedem Schritt zusätzlich den immer länger werdenden Verlauf der Aufgabe mit. Laut Branchenanalysen braucht eine typische mehrstufige Browser-Aufgabe 20.000 bis 60.000 Tokens, und obendrein zahlt das LLM Output-Preise, um jede Aktion auszuformulieren.
Der Punkt ist: Sobald eine Seite in eine Liste von Kandidaten-Elementen übersetzt ist, sind die meisten dieser Schritte keine Sprachprobleme. Es sind Multiple-Choice-Fragen. „Welches dieser Elemente soll ich anklicken?“ „Hat sich die Seite so verändert, wie wir erwartet haben?“ Das ist System-1-Arbeit – genau das, wofür Entscheidungsmodelle gebaut sind.
Wie Entscheidungsmodelle die Kosten von Browser-Aktionen um bis zu 50x senken
Um echte Zahlen auf den Tisch zu legen, vergleichen wir Jev mit Claude Haiku 4.5, einem der günstigsten LLMs eines großen KI-Labors. TypeSafe nennt Jev ein „System One model“ (also ein „System-1-Modell“) und übernimmt damit direkt Kahnemans Begriff.
- Jev kostet $0.042 pro Million Input-Tokens, und der Output ist kostenlos (auf OpenRouter). Antworten kommen typischerweise nach 70 bis 500 Millisekunden.
- Claude Haiku 4.5 kostet $1.00 pro Million Input-Tokens und $5.00 pro Million Output-Tokens.
Nimm einen einzelnen Routineschritt in einer Browser-Aufgabe, zum Beispiel das richtige Element zum Anklicken auswählen.
Mit einem LLM (Claude Haiku 4.5) für diesen Schritt: Der Agent schickt rund 12.000 Input-Tokens (Anweisungen, Tool-Definitionen, Seitenzustand und Aufgabenverlauf) und bekommt etwa 200 Output-Tokens zurück, die die Aktion beschreiben.
- Input: 12.000 × $1.00 / 1M = $0.0120
- Output: 200 × $5.00 / 1M = $0.0010
- Gesamt: etwa $0.013 pro Schritt
Mit einem Entscheidungsmodell (Jev) für denselben Schritt: Es braucht weder den Chatverlauf noch die Tool-Definitionen. Es bekommt das Ziel für diesen Schritt und die Kandidaten-Elemente, rund 6.000 Input-Tokens, und liefert eine Auswahl samt Konfidenz zurück. Der Output ist kostenlos.
- Input: 6.000 × $0.042 / 1M = $0.00025
- Output: $0
- Gesamt: etwa $0.00025 pro Schritt
Das ist ungefähr 50-mal weniger pro Routineschritt, und die Antwort kommt typischerweise in deutlich unter einer Sekunde.
Was das für eine ganze Aufgabe bedeutet
Eine echte Aufgabe braucht trotzdem irgendwo System 2: Das LLM muss deine Anfrage verstehen und planen, und manche Schritte sind wirklich mehrdeutig. Die Ersparnis bei einer kompletten Aufgabe hängt deshalb vor allem von einer Sache ab: wie oft das Entscheidungsmodell einen Schritt ans LLM zurückgibt.
Hier eine Aufgabe mit 20 Schritten, basierend auf den Zahlen pro Schritt von oben, mit einem Haiku-Planungsaufruf (~$0.0075) im hybriden Setup:
| Setup | Kosten pro Aufgabe | Kosten für 1.000 Aufgaben | Ersparnis ggü. reinem LLM |
|---|---|---|---|
| LLM (Haiku) für jeden Schritt | $0.260 | $260 | Basiswert |
| LLM plant, Entscheidungsmodell entscheidet, 10 % der Schritte eskaliert | $0.039 | $39 | ~7x günstiger |
| LLM plant, Entscheidungsmodell entscheidet, 0 % eskaliert | $0.013 | $13 | ~20x günstiger |
| Nur Entscheidungsmodell, bei einem wiederkehrenden oder vorab geplanten Workflow | $0.005 | $5 | ~50x günstiger |
Beispielhafte Schätzungen auf Basis öffentlicher Listenpreise. Die echten Zahlen hängen von der Seitengröße ab, davon, wie viele Schritte eine Aufgabe braucht, vom Prompt-Caching und davon, wie oft eine Aufgabe das LLM benötigt.
Das Muster ist eindeutig: Je mehr Routine in deiner Automatisierung steckt, desto näher kommst du an die 50x. Wiederkehrende Workflows, die du immer und immer wieder laufen lässt – dasselbe Formular ausfüllen, dasselbe Dashboard checken, dieselbe Art von Seite sichten –, sind genau das, wo Entscheidungsmodelle glänzen.
Unabhängige Tests weisen in dieselbe Richtung. In einem LiteLLM-Routing-Test kosteten 240 Jev-Aufrufe $0.0077 gegenüber $0.1985 für dieselben Aufrufe mit Claude Haiku 4.5 – etwa 26x günstiger.
Und schneller obendrein
Kosten sind nicht der einzige Vorteil. Ein unabhängiger Benchmark hat für Jev eine mediane Antwortzeit von 239 ms gemessen, gegenüber 687 ms bei Claude Haiku 4.5 – also ungefähr 3x schneller. Über eine Aufgabe mit 20 Schritten sind das etliche Sekunden, die du nicht auf deinen Browser warten musst. Derselbe Benchmark hat beim Entscheidungsmodell null fehlerhafte Ausgaben verzeichnet, weil es nur mit einer der vorgegebenen Optionen antworten kann.
Sind Entscheidungsmodelle genau genug?
Günstiger bringt nur etwas, wenn die Klicks auch sitzen. Hier die ehrliche Einschätzung.
Entscheidungsmodelle sind am stärksten bei engen, klar definierten Fragen. In einem veröffentlichten Benchmark zur Phishing-Erkennung kam Jev mit einer einzigen breiten Frage („Ist diese E-Mail Phishing?“) auf 62,6 % Genauigkeit, Haiku dagegen auf 81,3 %. Als dieselbe Aufgabe aber in fünf enge Fragen aufgeteilt wurde, erreichte das Entscheidungsmodell 95,0 % und lag damit vor Haiku mit 93,2 %.
Da ist sie wieder, die System-1-Lektion. Schnelles Denken ist hervorragend bei einfachen, konkreten Urteilen und schwach bei komplizierten, vagen. Das richtige Design teilt die Arbeit also auf:
- Lass das LLM die Aufgabe zerlegen – in kleine, konkrete Entscheidungen.
- Lass das Entscheidungsmodell jede kleine Entscheidung treffen, etwa „Welches Element?“ oder „Hat es geklappt?“
- Nutze die Konfidenz als Sicherheitsnetz. Antworten mit niedriger Konfidenz gehen zurück ans LLM, statt dass geraten wird.
Webseiten sind nicht vertrauenswürdiger Input. Sicherheitsforscher von Check Point haben gezeigt, dass Entscheidungsmodelle genauso per Prompt Injection angegriffen werden können wie LLMs. Ein fester Antwortraum begrenzt den Schaden (das Modell kann nur aus den Optionen wählen, die dein Code ihm vorgibt), beseitigt das Risiko aber nicht. Ein Grund mehr, warum bei SurfMind immer ein Mensch mit im Spiel bleibt: Browser-Aktionen fragen dich um Erlaubnis, bevor sie ausgeführt werden.
Entscheidungsmodelle in SurfMind: Schnelles und langsames Denken in deinem Browser
Mit den Browser-Aktionen von SurfMind klickt, tippt und scrollt KI für dich – direkt auf den Seiten, die du ohnehin gerade nutzt. Bisher lief jeder dieser Schritte über ein Sprachmodell.
Jetzt bekommt SurfMind ein Entscheidungsmodell als System 1, zum Start mit Jev:
- Dein gewähltes LLM ist System 2. Es versteht deine Anfrage, plant die Aufgabe, schreibt Texte und springt ein, sobald etwas unklar ist.
- Das Entscheidungsmodell ist System 1. Es übernimmt die routinemäßigen, wiederkehrenden Entscheidungen: das richtige Element finden, bestätigen, dass ein Schritt geklappt hat, Pop-ups und Banner erkennen.
- Die Konfidenz entscheidet über die Übergabe. Sichere Entscheidungen werden direkt umgesetzt. Unsichere gehen ans große Modell – so sparst du Geld, ohne bei der Zuverlässigkeit Abstriche zu machen.
- Du behältst die Kontrolle. Browser-Aktionen fragen dich weiterhin um Erlaubnis, bevor sie ausgeführt werden.
Das Ziel ist simpel: dieselbe Browser-Automatisierung, die du heute nutzt, zu einem Bruchteil der Kosten – potenziell bis zu 50-mal günstiger, als jeden Schritt allein durch Claude Haiku laufen zu lassen. Das passt zu dem, wie SurfMind schon immer funktioniert: Du zahlst nur, was du wirklich nutzt, und wählst das passende Modell für die jeweilige Aufgabe, statt für alles Premiumpreise zu zahlen.
Du willst KI, die in deinem Browser arbeitet – ohne dicke Rechnung?
SurfMind bringt 300+ KI-Modelle und Browser-Aktionen auf jede Seite, die du besuchst, und mit Entscheidungsmodellen werden die Routineklicks drastisch günstiger.
Ähnliche Beiträge
Alle anzeigen
BYOK: Bedeutung von 'Bring Your Own Key' und die Zukunft der KI-Tools
BYOK bedeutet Bring Your Own Key: Du verbindest deinen eigenen API-Schlüssel mit KI-Tools, statt Abos zu bezahlen. Erfahre, wie du 40–90 % sparst und in 5 Minuten startest.
Die besten kostenlosen OpenRouter-Modelle 2026 (und wie du sie wirklich nutzt)
OpenRouter bietet kostenlose Modelle von NVIDIA, Google, OpenAI und anderen. Welche sich lohnen, welche Limits gelten und wie du sie im Browser nutzt.
5 Wege zu KI auf Claude-/GPT-Niveau für unter 5 $ im Monat
Überspring die 20-Dollar-Abos. So nutzt du Top-Modelle wie Claude Sonnet 4.6, GPT-5.4 und Gemini 3 Flash für einen Bruchteil der Kosten – mit BYOK und cleverer Modellwahl.