
 Agregar a Chrome
¿Qué es un modelo de decisión de IA? Así es como Jev abarata 50 veces la automatización del navegador
Antes de hacer clic en cualquier cosa, un agente de IA para el navegador tiene que averiguar dónde hacer clic. Así que envía la página a un modelo de lenguaje y le pregunta: "¿Qué hago ahora?". El modelo lee la página entera, lo piensa y escribe una respuesta. Y entonces el agente hace clic.
Pagas por cada token de ese ida y vuelta. Por un solo clic, es una fracción de céntimo. Para una tarea de 20 pasos que ejecutas a diario, la cuenta sube rápido.
Y aquí viene lo curioso: la mayoría de esas preguntas son fáciles. "¿Cuál de estos botones es 'Añadir al carrito'?". "¿Se envió el formulario?". "¿Esto es un aviso de cookies?". Tú las responderías en una fracción de segundo, casi sin pensar. Pero la mayoría de los agentes de IA las responden por la vía lenta y cara: pidiéndole a un modelo de lenguaje completo que redacte una respuesta cada vez.
Para ese trabajo hay una herramienta mejor: el modelo de decisión de IA. La idea no es nueva, pero ganó muchísima atención en septiembre de 2026, cuando TypeSafe AI lanzó Jev, un modelo de decisión rápido, que cuesta prácticamente nada y funciona con casi cualquier pregunta que le hagas. En este artículo veremos qué son los modelos de decisión, por qué Pensar rápido, pensar despacio de Daniel Kahneman es la mejor forma de entenderlos y cómo repartir el trabajo entre modelos "rápidos" y "lentos" puede hacer que la automatización del navegador sea hasta 50 veces más barata que pasar cada paso por un LLM pequeño como Claude Haiku. Y es justo lo que estamos llevando a las acciones de navegador de SurfMind.
¿Qué es un modelo de decisión de IA?
Un modelo de decisión de IA toma decisiones. Y ya está. No escribe.
Le das una situación (por ejemplo, una página web) y una pregunta con un conjunto cerrado de respuestas posibles: "¿Cuál de estos 14 elementos es el botón de pago?" o "¿Hay un muro de inicio de sesión bloqueando esta página?". Elige una de tus respuestas y te dice qué tan seguro está. Sin párrafos, sin explicaciones, sin nada que limpiar después.
Eso lo hace sorprendentemente útil dentro del software, por dos motivos:
- La respuesta siempre encaja. Solo puede elegir entre las opciones que le diste, así que tu código puede actuar sobre el resultado al instante.
- Sabe qué tan seguro está. Un buen modelo de decisión está calibrado: cuando dice 90%, acierta aproximadamente el 90% de las veces. Esa confianza le indica al agente cuándo seguir adelante y cuándo pedir ayuda.
Jev es un buen ejemplo. Nunca escribe ni una palabra, responde en bastante menos de un segundo y cuesta una pequeña fracción de lo que cuesta un LLM. Más adelante usaremos sus precios publicados para calcular el ahorro.
Los modelos de decisión no son nuevos
La idea de un modelo aparte que solo emite juicios lleva años circulando, en varias formas:
- Los clasificadores ajustados (fine-tuned), como los modelos basados en BERT (desde 2018), son rápidos y precisos, pero cada uno solo sabe hacer una cosa. Un filtro de spam detecta spam, y nada más.
- Los clasificadores zero-shot, como los modelos de inferencia de lenguaje natural (NLI) y modelos abiertos más recientes como GLiClass, te dejan inventar las etiquetas en el momento de preguntar, sin necesidad de entrenamiento.
- Los modelos de recompensa y los clasificadores de seguridad, como Llama Guard de Meta, trabajan junto a otros modelos de IA y evalúan lo que producen.
- Los LLM pequeños usados como clasificadores no redactan una respuesta: solo leen qué tan probable es cada opción. Proyectos abiertos como OpenJev funcionan así.
Entonces, ¿por qué despegó Jev? Porque reúne todas estas ideas en un único modelo alojado que maneja casi cualquier pregunta que describas en lenguaje natural, te da una confianza calibrada y tiene un precio pensado para decisiones que ocurren millones de veces al día. Las comparativas independientes concluyen que las alternativas abiertas ya ganan en coste y privacidad si las ejecutas tú mismo, pero siguen por detrás de Jev en precisión cuando la pregunta es nueva para ellas. Por eso Jev es el ejemplo que usaremos a lo largo de este artículo.
Modelos de decisión vs. LLM
Un modelo de lenguaje grande (LLM) como Claude, GPT o Gemini genera su respuesta token a token. Aunque solo quieras una respuesta de una palabra, el LLM lo lee todo, "escribe" su respuesta y a menudo se pone a explicarse. Pagas por todo eso y luego cruzas los dedos para que la respuesta venga en el formato que pediste.
| LLM | Modelo de decisión | |
|---|---|---|
| Salida | Texto libre | Una respuesta entre las opciones que tú defines |
| ¿Puede escribir o razonar paso a paso? | Sí | No |
| ¿Respuesta siempre en tu formato? | Casi siempre, no siempre | Siempre |
| ¿Te dice qué tan seguro está? | No de forma fiable | Sí, con una probabilidad calibrada |
| Coste | Pagas tokens de entrada y de salida | Normalmente solo de entrada, a una fracción del precio |
| Velocidad | Segundos para respuestas largas | Normalmente bastante menos de un segundo |
| Su fuerte | Planificar, escribir, razonamiento abierto | Juicios rápidos, repetitivos y bien definidos |
Ninguno sustituye al otro. Lo interesante es lo que pasa cuando los combinas, y ahí es donde entra Kahneman.
Pensar rápido, pensar despacio: Sistema 1 y Sistema 2 para la IA
En su libro de 2011 Pensar rápido, pensar despacio, el psicólogo Daniel Kahneman describe dos modos del pensamiento humano:
- El Sistema 1 es rápido, automático y no requiere esfuerzo. Reconocer la cara de un amigo, leer una señal de stop, saber que 2 + 2 = 4. No decides hacerlo; simplemente ocurre.
- El Sistema 2 es lento, deliberado y exige esfuerzo. Planear un viaje, comparar dos ofertas de hipoteca, calcular 17 × 24. Requiere atención y energía, así que lo usas con moderación.
La clave es que la mayor parte de lo que hacemos a lo largo del día es Sistema 1. Solo recurrimos al Sistema 2 cuando algo es nuevo, difícil o sorprendente. Si tuvieras que pensar conscientemente cada paso al caminar, no llegarías a ningún sitio.
Los agentes de IA actuales solo tienen Sistema 2
La mayoría de los agentes de IA actuales usan un modelo de lenguaje grande para todo. El LLM planifica la tarea y luego ese mismo LLM decide cada clic, cada scroll y cada pulsación de tecla. Es como contratar a un analista sénior para planificar un proyecto y luego pedirle que haga también cada fotocopia en persona.
El resultado es predecible: agentes lentos, caros y que de vez en cuando se descarrilan por una respuesta mal formada en un paso que debería haber sido trivial.
Los modelos de decisión le dan a la IA un Sistema 1
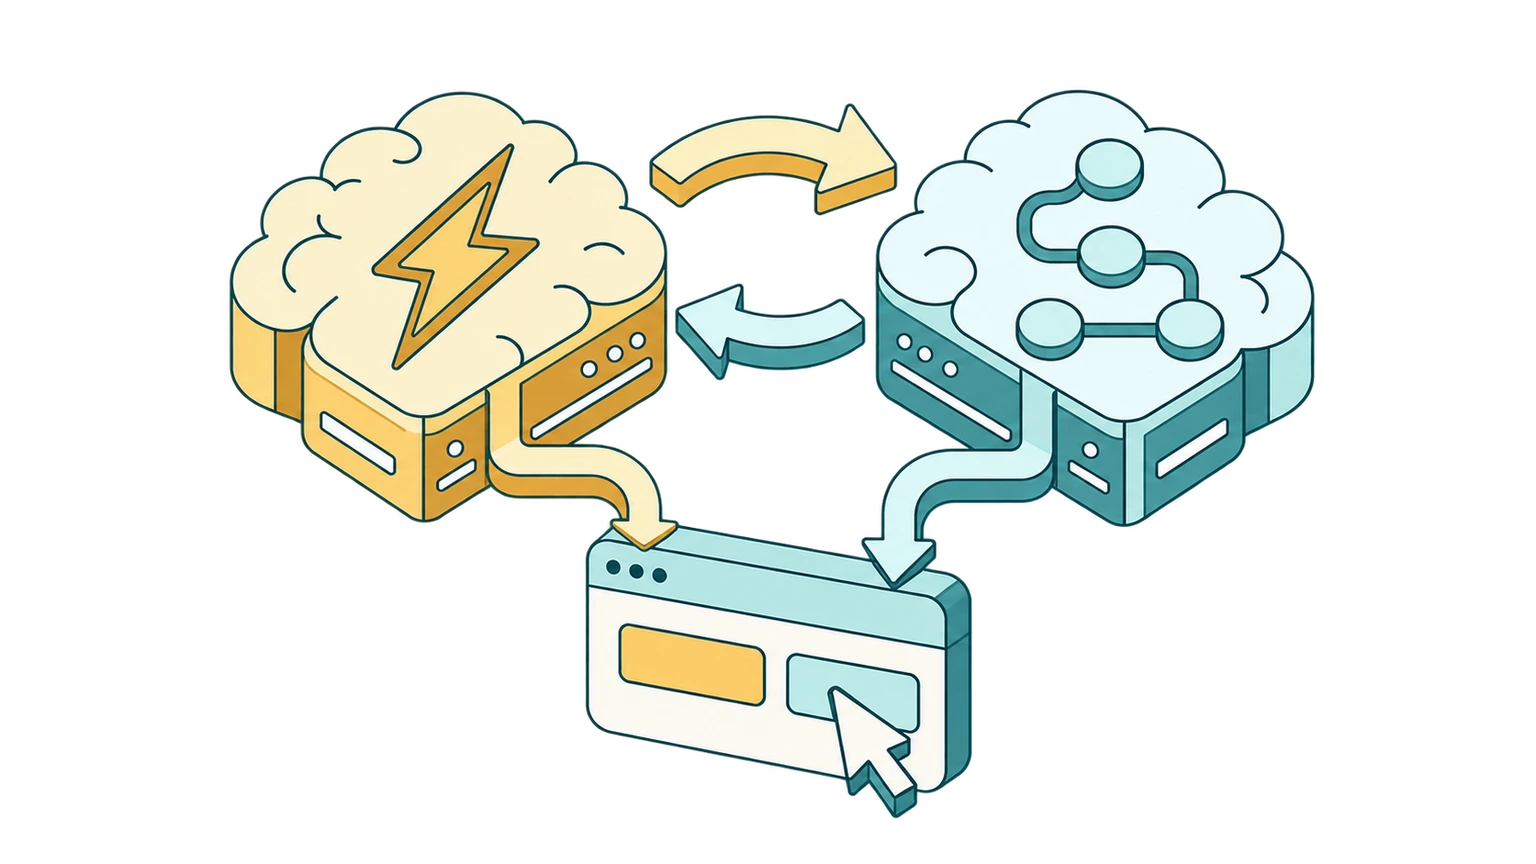
Un modelo de decisión es el Sistema 1 que faltaba: una capa de juicio rápida, barata y automática que se encarga de las decisiones rutinarias y sabe cuándo pasar el testigo.
Si juntas los dos, la arquitectura se parece mucho a la mente humana:
- El Sistema 2 (el LLM) entiende lo que pediste, traza el plan, escribe el texto que haga falta y se ocupa de cualquier cosa inusual.
- El Sistema 1 (el modelo de decisión) toma las muchas decisiones rápidas y repetitivas necesarias para ejecutar el plan.
- La confianza es la señal de relevo. Cuando el modelo de decisión está seguro, el agente actúa. Cuando no, la pregunta sube al LLM, igual que una persona cambia al pensamiento cuidadoso cuando algo no le cuadra.
Por qué la automatización del navegador sale cara hoy
Para ver de dónde sale el ahorro, fíjate en lo que hace realmente un agente de IA en el navegador en cada paso:
- Leer la página. El agente captura el estado de la página: un DOM simplificado, un árbol de accesibilidad o una captura de pantalla.
- Decidir. El modelo lee ese estado, junto con el objetivo y el historial de pasos anteriores, y elige la siguiente acción.
- Actuar. El agente hace clic, escribe o hace scroll.
- Comprobar. El modelo mira la nueva página para ver si funcionó.
Y vuelta a empezar. La parte cara es el paso 2. El estado de la página es grande, a menudo miles de tokens por paso, y muchos agentes además reenvían en cada paso el historial cada vez más largo de la tarea. Según análisis del sector, una tarea típica de varios pasos en el navegador consume entre 20.000 y 60.000 tokens, y encima el LLM paga precios de salida por escribir cada acción.
La cuestión es esta: una vez que la página se ha convertido en una lista de elementos candidatos, la mayoría de esos pasos no son problemas de lenguaje. Son preguntas tipo test. "¿En cuál de estos elementos debo hacer clic?". "¿Cambió la página como esperábamos?". Eso es trabajo de Sistema 1, justo aquello para lo que se construyen los modelos de decisión.
Cómo los modelos de decisión abaratan hasta 50 veces las acciones en el navegador
Para ponerle cifras reales al ahorro, compararemos Jev con Claude Haiku 4.5, uno de los LLM más asequibles de un gran laboratorio de IA. TypeSafe llama a Jev un "System One model" (un "modelo de Sistema 1"), tomando directamente el término de Kahneman.
- Jev cuesta $0.042 por millón de tokens de entrada, y la salida es gratis (en OpenRouter). Las respuestas suelen llegar en 70 a 500 milisegundos.
- Claude Haiku 4.5 cuesta $1.00 por millón de tokens de entrada y $5.00 por millón de tokens de salida.
Tomemos un único paso rutinario de una tarea en el navegador, como elegir el elemento correcto en el que hacer clic.
Usando un LLM (Claude Haiku 4.5) para ese paso: el agente envía unos 12.000 tokens de entrada (instrucciones, definiciones de herramientas, estado de la página e historial de la tarea) y recibe unos 200 tokens de salida que describen la acción.
- Entrada: 12.000 × $1.00 / 1M = $0.0120
- Salida: 200 × $5.00 / 1M = $0.0010
- Total: unos $0.013 por paso
Usando un modelo de decisión (Jev) para el mismo paso: no necesita el historial del chat ni las definiciones de herramientas. Recibe el objetivo de este paso y los elementos candidatos, unos 6.000 tokens de entrada, y devuelve una elección con su nivel de confianza. La salida es gratis.
- Entrada: 6.000 × $0.042 / 1M = $0.00025
- Salida: $0
- Total: unos $0.00025 por paso
Eso es aproximadamente 50 veces menos por paso rutinario, y la respuesta suele llegar en bastante menos de un segundo.
Qué significa eso para una tarea completa
Una tarea real sigue necesitando el Sistema 2 en algún momento: el LLM tiene que entender tu petición y planificarla, y algunos pasos serán genuinamente ambiguos. Así que el ahorro en una tarea completa depende sobre todo de una cosa: con qué frecuencia el modelo de decisión le devuelve un paso al LLM.
Aquí tienes una tarea de 20 pasos, con las cifras por paso de arriba y una llamada de planificación a Haiku (~$0.0075) en la configuración híbrida:
| Configuración | Coste por tarea | Coste por 1.000 tareas | Ahorro frente a solo LLM |
|---|---|---|---|
| LLM (Haiku) en cada paso | $0.260 | $260 | referencia |
| El LLM planifica, el modelo de decisión decide, 10% de pasos escalados | $0.039 | $39 | ~7 veces más barato |
| El LLM planifica, el modelo de decisión decide, 0% escalados | $0.013 | $13 | ~20 veces más barato |
| Solo modelo de decisión, en un flujo repetido o planificado de antemano | $0.005 | $5 | ~50 veces más barato |
Estimaciones ilustrativas basadas en precios públicos de tarifa. Las cifras reales dependen del tamaño de la página, de cuántos pasos requiera la tarea, del caché de prompts y de la frecuencia con la que la tarea necesite el LLM.
El patrón es claro: cuanto más rutinaria sea tu automatización, más te acercas al extremo de las 50 veces. Los flujos repetitivos que ejecutas una y otra vez, como rellenar el mismo formulario, revisar el mismo panel o clasificar el mismo tipo de página, son el terreno donde brillan los modelos de decisión.
Las pruebas independientes apuntan en la misma dirección. En una prueba de enrutamiento con LiteLLM, 240 llamadas a Jev costaron $0.0077 frente a $0.1985 por las mismas llamadas en Claude Haiku 4.5, unas 26 veces menos.
Y encima, más rápido
El coste no es la única ventaja. Un benchmark independiente midió un tiempo de respuesta mediano de 239 ms para Jev frente a 687 ms para Claude Haiku 4.5, aproximadamente 3 veces más rápido. En una tarea de 20 pasos, son muchos segundos que te ahorras esperando al navegador. El mismo benchmark registró cero salidas mal formadas del modelo de decisión, ya que solo puede responder con una de las opciones que se le dieron.
¿Son lo bastante precisos los modelos de decisión?
Que sea más barato solo importa si los clics son correctos. Seamos sinceros.
Los modelos de decisión rinden mejor con preguntas concretas y bien definidas. En un benchmark publicado de detección de phishing, hacerle a Jev una sola pregunta amplia ("¿este correo es phishing?") obtuvo un 62,6% de precisión, frente al 81,3% de Haiku. Pero cuando la misma tarea se dividió en cinco preguntas concretas, el modelo de decisión llegó al 95,0%, por delante del 93,2% de Haiku.
Es otra vez la lección del Sistema 1. El pensamiento rápido es excelente con juicios simples y específicos, y flojo con los complicados y vagos. Así que el buen diseño reparte el trabajo:
- Deja que el LLM divida la tarea en decisiones pequeñas y concretas.
- Deja que el modelo de decisión responda cada decisión pequeña, como "¿qué elemento?" o "¿funcionó?".
- Usa la confianza como red de seguridad. Las respuestas con poca confianza vuelven al LLM en lugar de ir a ciegas.
Las páginas web son entradas no confiables. Investigadores de seguridad de Check Point han demostrado que los modelos de decisión pueden ser objetivo de inyección de prompts igual que los LLM. Un espacio de respuestas cerrado limita el daño (el modelo solo puede elegir entre las opciones que le dio tu código), pero no elimina el riesgo. Es una razón más por la que SurfMind mantiene a una persona en el proceso: las acciones de navegador te piden permiso antes de ejecutarse.
Modelos de decisión en SurfMind: pensamiento rápido y lento en tu navegador
Las acciones de navegador de SurfMind permiten que la IA haga clic, escriba y haga scroll por ti, directamente en las páginas que ya estás usando. Hasta ahora, cada uno de esos pasos pasaba por un modelo de lenguaje.
Estamos añadiendo un modelo de decisión como Sistema 1 de SurfMind, empezando por Jev:
- El LLM que elijas es el Sistema 2. Entiende tu petición, planifica la tarea, escribe el texto necesario e interviene cuando algo no está claro.
- El modelo de decisión es el Sistema 1. Se encarga de las decisiones rutinarias y repetidas: encontrar el elemento correcto, confirmar que un paso funcionó, detectar pop-ups y banners.
- La confianza decide el relevo. Las decisiones seguras siguen adelante. Las dudosas pasan al modelo completo, así ahorras dinero sin sacrificar fiabilidad.
- Tú mantienes el control. Las acciones de navegador siguen pidiéndote permiso antes de ejecutarse.
El objetivo es sencillo: la misma automatización del navegador que usas hoy, a una fracción del coste, y potencialmente hasta 50 veces menos que pasar cada paso solo por Claude Haiku. Encaja con la forma en que SurfMind ha funcionado siempre: paga solo por lo que usas y elige el modelo adecuado para cada tarea en lugar de pagar precios premium por todo.
¿Quieres una IA que trabaje en tu navegador sin que se dispare la factura?
SurfMind lleva más de 300 modelos de IA y acciones de navegador a cada página que visitas, y con los modelos de decisión, los clics rutinarios salen muchísimo más baratos.
Publicaciones relacionadas
Ver todo
Significado de BYOK: qué es 'Bring Your Own Key' y por qué es el futuro de las herramientas de IA
BYOK significa Bring Your Own Key: conectas tu propia clave API a herramientas de IA en vez de pagar suscripciones. Descubre cómo ahorrar un 40–90 % y empezar en 5 minutos.
Los mejores modelos gratuitos de OpenRouter en 2026 (y cómo usarlos de verdad)
OpenRouter reúne modelos gratuitos de NVIDIA, Google, OpenAI y más. Descubre cuáles merecen la pena, cuáles son sus límites y cómo chatear con ellos en el navegador.
5 formas de conseguir IA de calidad Claude/GPT por menos de 5 $ al mes
Olvídate de las suscripciones de 20 $ al mes. Descubre cómo acceder a modelos de primer nivel como Claude Sonnet 4.6, GPT-5.4 y Gemini 3 Flash por una fracción del coste con BYOK y una buena selección de modelos.