
 Ajouter à Chrome
Qu'est-ce qu'un modèle de décision IA ? Comment Jev rend l'automatisation du navigateur 50 fois moins chère
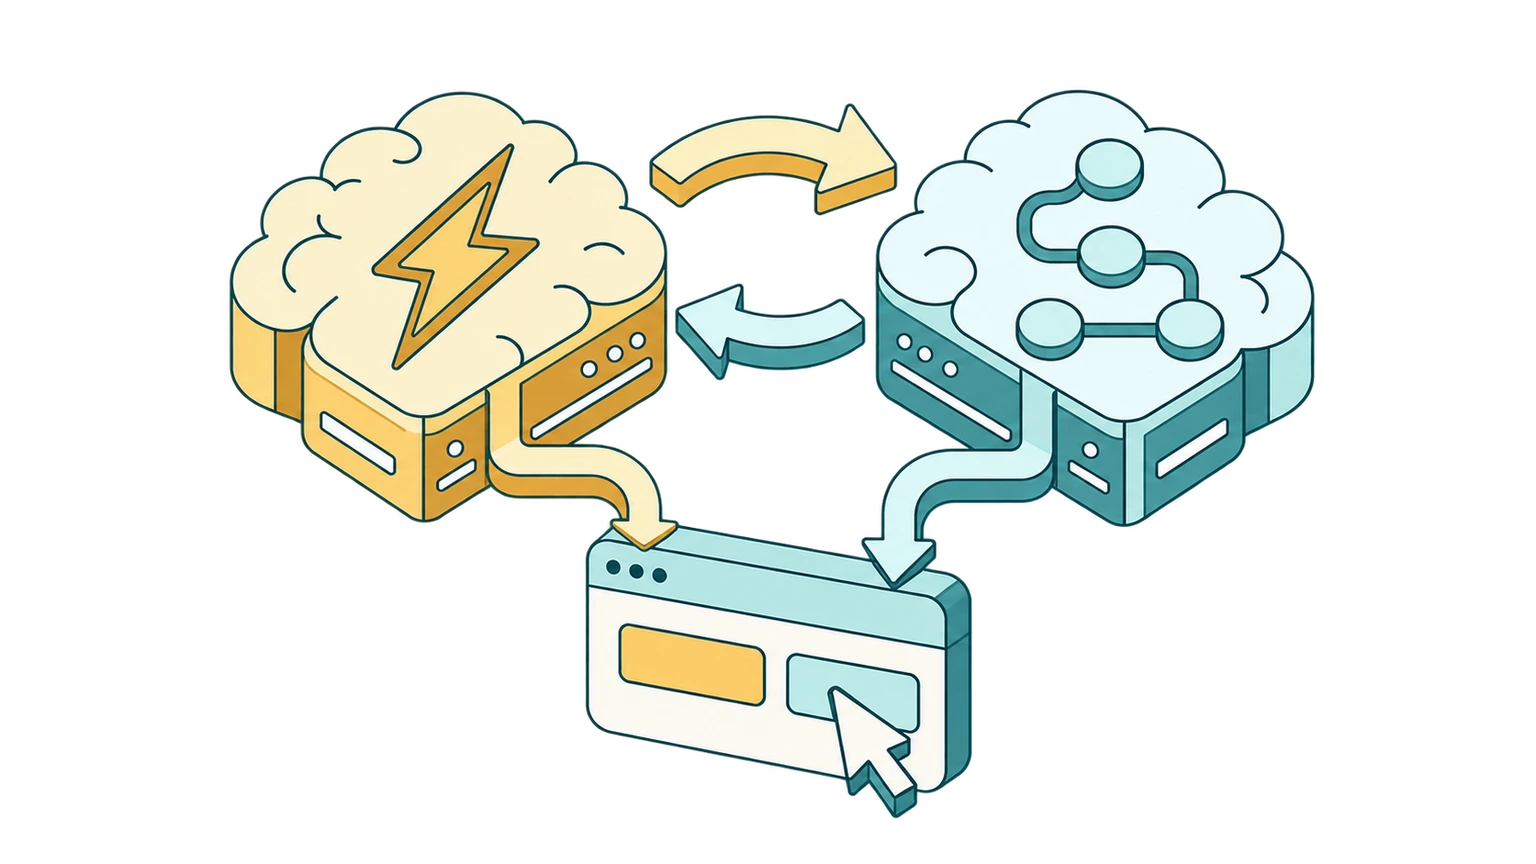
Avant de cliquer sur quoi que ce soit, un agent IA de navigation doit d'abord savoir où cliquer. Il envoie donc la page à un modèle de langage et lui demande : « Qu'est-ce que je fais maintenant ? » Le modèle lit toute la page, réfléchit, puis rédige une réponse. Et seulement ensuite, l'agent clique.
Chaque token de cet aller-retour vous est facturé. Pour un clic, ce n'est qu'une fraction de centime. Pour une tâche de 20 étapes que vous lancez tous les jours, la note grimpe vite.
Et le plus drôle, c'est que la plupart de ces questions sont faciles. « Lequel de ces boutons est "Ajouter au panier" ? » « Le formulaire a-t-il bien été envoyé ? » « Est-ce une bannière de cookies ? » Vous y répondriez en une fraction de seconde, sans même y penser. Pourtant, la plupart des agents IA y répondent de la manière la plus lente et la plus coûteuse qui soit : en demandant à un modèle de langage complet de rédiger une réponse, à chaque fois.
Il existe un meilleur outil pour ce travail : le modèle de décision IA. L'idée ne date pas d'hier, mais elle a fait beaucoup parler d'elle en septembre 2026 quand TypeSafe AI a lancé Jev, un modèle de décision rapide, qui ne coûte presque rien à faire tourner et qui s'en sort sur à peu près n'importe quelle question. Dans cet article, on va voir ce que sont les modèles de décision, pourquoi le livre de Daniel Kahneman Système 1 / Système 2 : Les deux vitesses de la pensée est la meilleure grille de lecture pour les comprendre, et comment répartir le travail entre modèles « rapides » et « lents » peut rendre l'automatisation du navigateur jusqu'à 50 fois moins chère que de faire passer chaque étape par un petit LLM comme Claude Haiku. C'est aussi exactement ce que nous intégrons aux actions de navigateur de SurfMind.
Qu'est-ce qu'un modèle de décision IA ?
Un modèle de décision IA prend des décisions. Point. Il n'écrit pas.
Vous lui donnez une situation (une page web, par exemple) et une question avec un ensemble fixe de réponses possibles : « Lequel de ces 14 éléments est le bouton de paiement ? » ou « Un mur de connexion bloque-t-il cette page ? » Il choisit l'une de vos réponses et vous indique à quel point il en est sûr. Pas de paragraphes, pas d'explications, rien à nettoyer derrière.
C'est ce qui le rend étonnamment utile dans un logiciel, pour deux raisons :
- La réponse est toujours exploitable. Il ne peut choisir que parmi les options que vous lui avez données, donc votre code peut agir sur le résultat immédiatement.
- Il sait à quel point il est sûr de lui. Un bon modèle de décision est calibré : quand il annonce 90 %, il a raison environ 90 % du temps. Cette confiance indique à l'agent quand foncer et quand demander de l'aide.
Jev en est un bon exemple. Il n'écrit jamais un mot, répond en bien moins d'une seconde et coûte une petite fraction du prix d'un LLM. On utilisera ses tarifs publics plus loin pour chiffrer les économies.
Les modèles de décision n'ont rien de nouveau
L'idée d'un modèle à part, dédié uniquement au jugement, existe depuis des années, sous différentes formes :
- Les classifieurs fine-tunés, comme les modèles basés sur BERT (depuis 2018), sont rapides et précis, mais chacun ne sait faire qu'une seule chose. Un filtre anti-spam détecte le spam, et c'est tout.
- Les classifieurs zero-shot, comme les modèles d'inférence en langage naturel (NLI) et des modèles ouverts plus récents tels que GLiClass, vous laissent inventer les étiquettes au moment de la question, sans aucun entraînement.
- Les modèles de récompense et les classifieurs de sécurité, comme Llama Guard de Meta, se placent à côté d'autres modèles d'IA et jugent ce qu'ils produisent.
- Les petits LLM utilisés comme classifieurs ne rédigent pas de réponse : ils lisent simplement la probabilité de chaque option. Des projets ouverts comme OpenJev fonctionnent ainsi.
Alors pourquoi Jev a-t-il décollé ? Il réunit toutes ces idées dans un seul modèle hébergé, capable de traiter presque n'importe quelle question formulée en langage courant, avec une confiance calibrée, et à un prix pensé pour des décisions prises des millions de fois par jour. Des comparatifs indépendants montrent que les alternatives ouvertes l'emportent déjà sur le coût et la confidentialité si vous les hébergez vous-même, mais restent derrière Jev en précision face à une question inédite. C'est pour cela que Jev nous servira d'exemple tout au long de cet article.
Modèles de décision vs LLM
Un grand modèle de langage (LLM) comme Claude, GPT ou Gemini génère sa réponse un token à la fois. Même quand vous ne voulez qu'un seul mot, le LLM lit tout, « rédige » sa réponse et, souvent, se justifie. Vous payez pour tout ça, puis vous croisez les doigts pour que la réponse soit au format demandé.
| LLM | Modèle de décision | |
|---|---|---|
| Sortie | Texte libre | Une réponse parmi les options que vous définissez |
| Peut-il rédiger ou raisonner étape par étape ? | Oui | Non |
| Réponse toujours au bon format ? | Généralement, pas toujours | Toujours |
| Indique-t-il son degré de certitude ? | Pas de façon fiable | Oui, une probabilité calibrée |
| Coût | Tokens d'entrée et de sortie facturés | En général l'entrée seulement, pour une fraction du prix |
| Vitesse | Plusieurs secondes pour les réponses longues | En général bien moins d'une seconde |
| Point fort | Planification, rédaction, raisonnement ouvert | Jugements rapides, répétés et bien définis |
Aucun ne remplace l'autre. Le plus intéressant, c'est ce qui se passe quand on les combine, et c'est là que Kahneman entre en scène.
Système 1 et Système 2 : penser vite et lentement, version IA
Dans son livre de 2011 Système 1 / Système 2 : Les deux vitesses de la pensée, le psychologue Daniel Kahneman décrit deux modes de pensée humaine :
- Le Système 1 est rapide, automatique et sans effort. Reconnaître le visage d'un ami, lire un panneau stop, savoir que 2 + 2 = 4. Vous ne décidez pas de le faire : ça se fait tout seul.
- Le Système 2 est lent, réfléchi et coûteux en effort. Organiser un voyage, comparer deux offres de prêt immobilier, calculer 17 × 24. Il demande de l'attention et de l'énergie, alors on l'utilise avec parcimonie.
L'idée clé : l'essentiel de ce que nous faisons dans une journée relève du Système 1. Nous ne faisons appel au Système 2 que lorsque quelque chose est nouveau, difficile ou surprenant. Si vous deviez réfléchir consciemment à chaque pas en marchant, vous n'arriveriez jamais nulle part.
Les agents IA actuels n'ont qu'un Système 2
La plupart des agents IA actuels utilisent un grand modèle de langage pour tout. Le LLM planifie la tâche, puis ce même LLM décide de chaque clic, de chaque défilement et de chaque frappe au clavier. C'est comme embaucher un analyste senior pour piloter un projet, puis lui demander de faire lui-même toutes les photocopies.
Le résultat est prévisible : des agents lents, coûteux, et qui déraillent de temps en temps à cause d'une réponse mal formée sur une étape qui aurait dû être triviale.
Les modèles de décision donnent un Système 1 à l'IA
Un modèle de décision, c'est le Système 1 qui manquait : une couche de jugement rapide, bon marché et automatique qui gère les décisions de routine, et qui sait quand passer la main.
Associez les deux, et l'architecture ressemble beaucoup à l'esprit humain :
- Le Système 2 (le LLM) comprend ce que vous avez demandé, établit le plan, rédige les textes éventuels et gère tout ce qui sort de l'ordinaire.
- Le Système 1 (le modèle de décision) prend les nombreuses petites décisions rapides et répétitives nécessaires pour exécuter le plan.
- La confiance sert de signal de relais. Quand le modèle de décision est sûr de lui, l'agent agit. Sinon, la question remonte au LLM, exactement comme une personne passe en mode réflexion quand quelque chose cloche.
Pourquoi l'automatisation du navigateur coûte cher aujourd'hui
Pour comprendre d'où viennent les économies, regardons ce que fait réellement un agent IA de navigation à chaque étape :
- Lire la page. L'agent capture l'état de la page : un DOM simplifié, un arbre d'accessibilité ou une capture d'écran.
- Décider. Le modèle lit cet état, ainsi que l'objectif et l'historique des étapes précédentes, puis choisit l'action suivante.
- Agir. L'agent clique, tape du texte ou fait défiler la page.
- Vérifier. Le modèle examine la nouvelle page pour voir si l'action a fonctionné.
Et on recommence. L'étape qui coûte cher, c'est la 2. L'état de la page est volumineux, souvent des milliers de tokens par étape, et beaucoup d'agents renvoient en plus l'historique complet de la tâche, qui ne cesse de grossir, à chaque étape. Selon les analyses du secteur, une tâche de navigation typique en plusieurs étapes consomme entre 20 000 et 60 000 tokens, et le LLM paie en plus le tarif de sortie pour rédiger chaque action.
Le truc, c'est qu'une fois la page transformée en liste d'éléments candidats, la plupart de ces étapes ne sont pas des problèmes de langage. Ce sont des QCM. « Sur lequel de ces éléments dois-je cliquer ? » « La page a-t-elle changé comme prévu ? » C'est du travail de Système 1, exactement ce pour quoi les modèles de décision sont conçus.
Comment les modèles de décision divisent jusqu'à 50 fois le coût des actions dans le navigateur
Pour mettre de vrais chiffres sur ces économies, nous allons comparer Jev à Claude Haiku 4.5, l'un des LLM les plus abordables d'un grand laboratoire d'IA. TypeSafe présente Jev comme un « System One model » (un « modèle Système 1 »), en reprenant directement le terme de Kahneman.
- Jev coûte $0.042 par million de tokens d'entrée, et la sortie est gratuite (sur OpenRouter). Les réponses arrivent généralement en 70 à 500 millisecondes.
- Claude Haiku 4.5 coûte $1.00 par million de tokens d'entrée et $5.00 par million de tokens de sortie.
Prenons une seule étape de routine dans une tâche de navigation, comme choisir le bon élément sur lequel cliquer.
Avec un LLM (Claude Haiku 4.5) pour cette étape : l'agent envoie environ 12 000 tokens d'entrée (instructions, définitions d'outils, état de la page et historique de la tâche) et reçoit environ 200 tokens de sortie décrivant l'action.
- Entrée : 12 000 × $1.00 / 1M = $0.0120
- Sortie : 200 × $5.00 / 1M = $0.0010
- Total : environ $0.013 par étape
Avec un modèle de décision (Jev) pour la même étape : pas besoin de l'historique de conversation ni des définitions d'outils. Il reçoit l'objectif de l'étape et les éléments candidats, soit environ 6 000 tokens d'entrée, et renvoie un choix accompagné d'un niveau de confiance. La sortie est gratuite.
- Entrée : 6 000 × $0.042 / 1M = $0.00025
- Sortie : $0
- Total : environ $0.00025 par étape
Soit à peu près 50 fois moins cher par étape de routine, avec une réponse qui arrive généralement en bien moins d'une seconde.
Ce que ça donne sur une tâche complète
Une vraie tâche a tout de même besoin d'un Système 2 quelque part : le LLM doit comprendre votre demande et la planifier, et certaines étapes seront réellement ambiguës. Les économies sur une tâche complète dépendent donc avant tout d'une chose : la fréquence à laquelle le modèle de décision renvoie une étape au LLM.
Voici une tâche de 20 étapes, avec les chiffres par étape ci-dessus et un appel de planification à Haiku (~$0.0075) dans la configuration hybride :
| Configuration | Coût par tâche | Coût pour 1 000 tâches | Économies vs LLM seul |
|---|---|---|---|
| LLM (Haiku) à chaque étape | $0.260 | $260 | référence |
| Le LLM planifie, le modèle de décision décide, 10 % des étapes remontées | $0.039 | $39 | ~7 fois moins cher |
| Le LLM planifie, le modèle de décision décide, 0 % remonté | $0.013 | $13 | ~20 fois moins cher |
| Modèle de décision seul, sur un workflow répétitif ou planifié à l'avance | $0.005 | $5 | ~50 fois moins cher |
Estimations indicatives basées sur les tarifs publics. Les chiffres réels dépendent de la taille des pages, du nombre d'étapes d'une tâche, du prompt caching et de la fréquence à laquelle une tâche a besoin du LLM.
La tendance est claire : plus votre automatisation est routinière, plus vous vous rapprochez du facteur 50. Les workflows répétitifs que vous lancez encore et encore, comme remplir le même formulaire, consulter le même tableau de bord ou trier le même type de page, sont le terrain de jeu idéal des modèles de décision.
Les tests indépendants vont dans le même sens. Dans un test de routage avec LiteLLM, 240 appels à Jev ont coûté $0.0077, contre $0.1985 pour les mêmes appels sur Claude Haiku 4.5, soit environ 26 fois moins.
Et plus rapide, en prime
Le coût n'est pas le seul avantage. Un benchmark indépendant a mesuré un temps de réponse médian de 239 ms pour Jev contre 687 ms pour Claude Haiku 4.5, soit environ 3 fois plus rapide. Sur une tâche de 20 étapes, ce sont de précieuses secondes que vous ne passez pas à attendre votre navigateur. Le même benchmark n'a relevé aucune sortie mal formée de la part du modèle de décision, puisqu'il ne peut répondre qu'avec l'une des options qu'on lui a fournies.
Les modèles de décision sont-ils assez précis ?
Moins cher, ça ne compte que si les clics sont les bons. Voici le tableau, sans fard.
Les modèles de décision excellent sur les questions étroites et bien définies. Dans un benchmark publié sur la détection de phishing, poser à Jev une seule question large (« cet e-mail est-il du phishing ? ») a donné 62,6 % de précision, contre 81,3 % pour Haiku. Mais quand la même tâche a été découpée en cinq questions ciblées, le modèle de décision a atteint 95,0 %, devant les 93,2 % de Haiku.
On retrouve la leçon du Système 1. La pensée rapide est excellente pour les jugements simples et précis, et médiocre pour les questions compliquées et floues. La bonne architecture répartit donc le travail :
- Laissez le LLM découper la tâche en petites décisions concrètes.
- Laissez le modèle de décision trancher chaque petite décision, comme « quel élément ? » ou « est-ce que ça a marché ? »
- Utilisez la confiance comme filet de sécurité. Les réponses peu sûres repartent vers le LLM au lieu de jouer aux devinettes.
Les pages web sont des entrées non fiables. Des chercheurs en sécurité de Check Point ont montré que les modèles de décision peuvent être visés par des injections de prompt, tout comme les LLM. Un espace de réponses fixe limite les dégâts (le modèle ne peut choisir que parmi les options fournies par votre code), mais n'élimine pas le risque. C'est une raison de plus pour laquelle SurfMind garde un humain dans la boucle : les actions de navigateur vous demandent votre autorisation avant de s'exécuter.
Les modèles de décision dans SurfMind : penser vite et lentement dans votre navigateur
Les actions de navigateur de SurfMind permettent à l'IA de cliquer, de taper du texte et de faire défiler la page à votre place, directement dans les pages que vous utilisez déjà. Jusqu'ici, chacune de ces étapes passait par un modèle de langage.
Nous ajoutons un modèle de décision comme Système 1 de SurfMind, à commencer par Jev :
- Le LLM de votre choix joue le rôle du Système 2. Il comprend votre demande, planifie la tâche, rédige les textes éventuels et intervient dès que quelque chose n'est pas clair.
- Le modèle de décision joue le rôle du Système 1. Il gère les décisions routinières et répétitives : trouver le bon élément, confirmer qu'une étape a fonctionné, repérer les pop-ups et les bannières.
- La confiance décide du relais. Les décisions sûres passent directement. Les incertaines remontent au modèle complet : vous économisez sans rien sacrifier côté fiabilité.
- Vous gardez la main. Les actions de navigateur vous demandent toujours votre autorisation avant de s'exécuter.
L'objectif est simple : la même automatisation du navigateur que vous utilisez aujourd'hui, pour une fraction du prix, et potentiellement jusqu'à 50 fois moins cher que de tout faire passer par Claude Haiku seul. C'est dans la droite ligne de la philosophie de SurfMind : ne payer que ce que vous utilisez, et choisir le modèle adapté à chaque tâche au lieu de payer le prix fort pour tout.
Envie d'une IA qui travaille dans votre navigateur sans faire exploser la facture ?
SurfMind met plus de 300 modèles d'IA et des actions de navigateur à portée de main sur chaque page que vous visitez, et avec les modèles de décision, les clics de routine deviennent nettement moins chers.
Articles similaires
Voir tout
BYOK : signification de 'Bring Your Own Key' et avenir des outils IA
BYOK signifie Bring Your Own Key : utilisez votre propre clé API dans les outils IA plutôt que de payer des abonnements. Découvrez comment économiser 40 à 90 % et démarrer en 5 minutes.
Les meilleurs modèles OpenRouter gratuits en 2026 (et comment vraiment les utiliser)
OpenRouter propose des modèles gratuits de NVIDIA, Google, OpenAI et d’autres acteurs. Voici ceux qui valent le détour, leurs limites et comment les utiliser dans votre navigateur.
5 façons d'obtenir une IA de qualité Claude/GPT pour moins de 5 $/mois
Évitez les abonnements à 20 $/mois. Découvrez comment accéder à des modèles d'IA de premier ordre comme Claude Sonnet 4.6, GPT-5.4 et Gemini 3 Flash pour une fraction du prix, grâce au BYOK et à un choix malin de modèles.