
 Adicionar ao Chrome
O que é um modelo de decisão de IA? Como o Jev deixa a automação de navegador 50 vezes mais barata
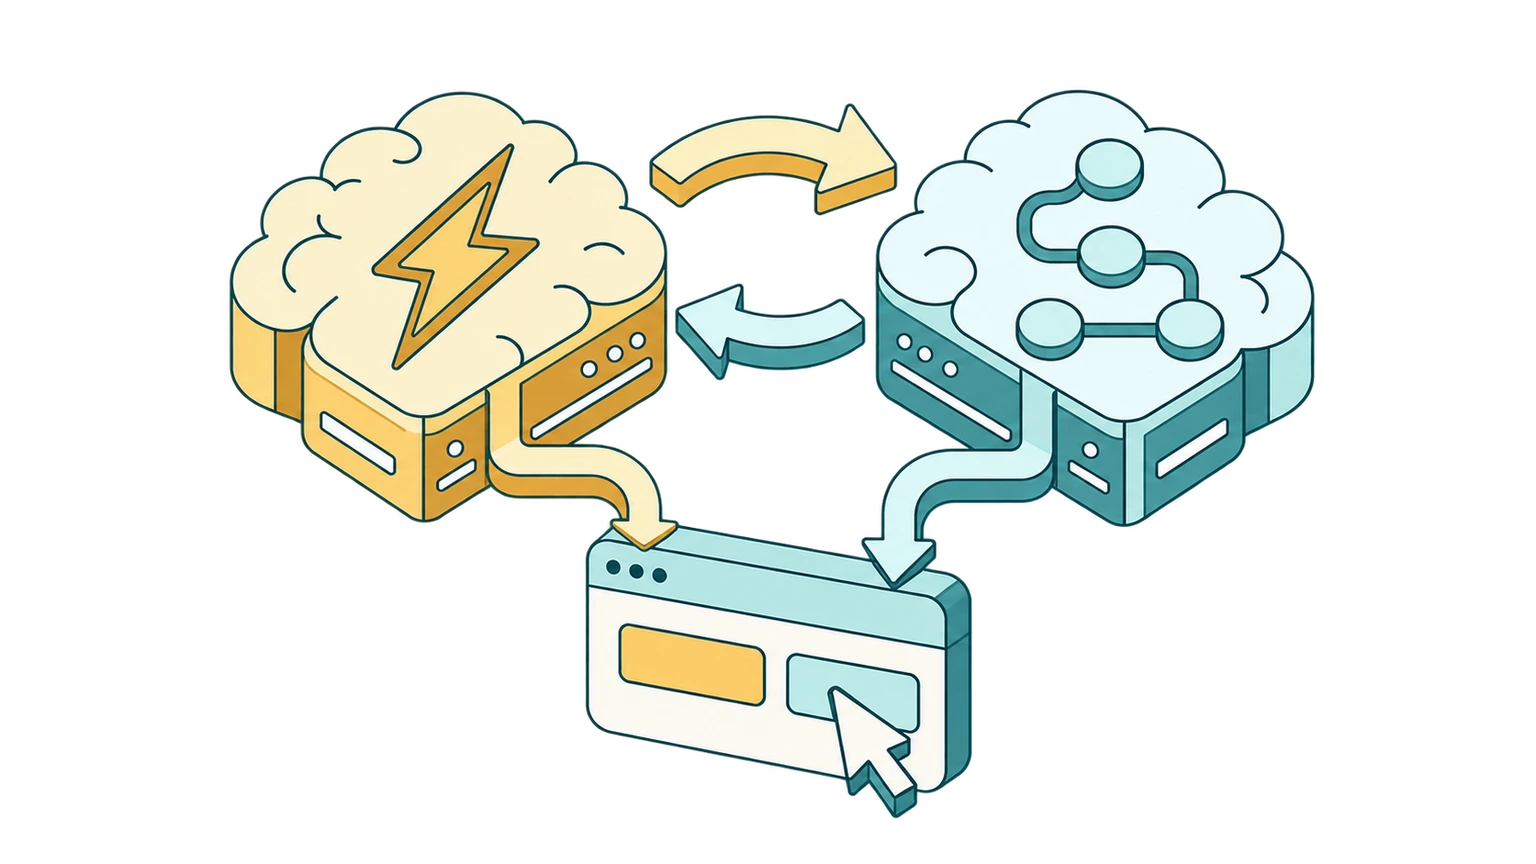
Antes de um agente de IA clicar em qualquer coisa no navegador, ele precisa descobrir onde clicar. Então ele manda a página para um modelo de linguagem e pergunta: "O que eu faço agora?" O modelo lê a página inteira, pensa no assunto e escreve uma resposta. Só aí o agente clica.
Você paga por cada token dessa ida e volta. Para um clique, é uma fração de centavo. Para uma tarefa de 20 passos que você roda todo dia, a conta cresce rápido.
E aqui vem a parte curiosa: a maioria dessas perguntas é fácil. "Qual destes botões é o 'Adicionar ao carrinho'?" "O formulário foi enviado?" "Isso é um banner de cookies?" Você responderia em uma fração de segundo, quase sem pensar. Mesmo assim, a maioria dos agentes de IA responde do jeito lento e caro: pedindo para um modelo de linguagem completo escrever uma resposta toda santa vez.
Existe uma ferramenta melhor para esse trabalho: o modelo de decisão de IA. A ideia não é nova, mas ganhou muito mais atenção em setembro de 2026, quando a TypeSafe AI lançou o Jev, um modelo de decisão rápido, que custa quase nada para rodar e funciona com praticamente qualquer pergunta que você jogar nele. Neste post, vamos ver o que são modelos de decisão, por que Rápido e devagar: duas formas de pensar, de Daniel Kahneman, é o melhor jeito de entendê-los e como dividir o trabalho entre modelos "rápidos" e "lentos" pode deixar a automação de navegador até 50 vezes mais barata do que rodar cada passo em um LLM pequeno como o Claude Haiku. E é exatamente isso que estamos trazendo para as ações de navegador do SurfMind.
O que é um modelo de decisão de IA?
Um modelo de decisão de IA toma decisões. Só isso. Ele não escreve.
Você entrega uma situação (digamos, uma página da web) e uma pergunta com um conjunto fixo de respostas possíveis: "Qual destes 14 elementos é o botão de finalizar compra?" ou "Tem uma tela de login bloqueando esta página?" Ele escolhe uma das suas respostas e diz o quanto tem certeza. Sem parágrafos, sem explicações, nada para limpar depois.
Isso o torna surpreendentemente útil dentro de um software, por dois motivos:
- A resposta sempre encaixa. Ele só pode escolher entre as opções que você deu, então seu código pode agir sobre o resultado na hora.
- Ele sabe o quanto tem certeza. Um bom modelo de decisão é calibrado: quando ele diz 90%, acerta cerca de 90% das vezes. Essa confiança mostra ao agente quando seguir em frente e quando pedir ajuda.
O Jev é um bom exemplo. Ele nunca escreve uma palavra, responde em bem menos de um segundo e custa uma pequena fração do que um LLM custa. Mais adiante, vamos usar os preços publicados dele para calcular a economia.
Modelos de decisão não são novidade
A ideia de um modelo separado que só faz julgamentos existe há anos, em algumas formas diferentes:
- Classificadores com fine-tuning, como os modelos baseados em BERT (desde 2018), são rápidos e precisos, mas cada um só sabe fazer uma coisa. Um filtro de spam detecta spam, e pronto.
- Classificadores zero-shot, como os modelos de inferência de linguagem natural (NLI) e modelos abertos mais novos como o GLiClass, deixam você inventar os rótulos na hora de perguntar, sem precisar de treinamento.
- Modelos de recompensa e classificadores de segurança, como o Llama Guard da Meta, ficam ao lado de outros modelos de IA e avaliam o que eles produzem.
- LLMs pequenos usados como classificadores pulam a parte de escrever uma resposta e só leem a probabilidade de cada opção. Projetos abertos como o OpenJev funcionam assim.
Então por que o Jev decolou? Ele junta essas ideias em um único modelo hospedado que lida com quase qualquer pergunta descrita em linguagem natural, entrega uma confiança calibrada e tem preço pensado para decisões que acontecem milhões de vezes por dia. Comparações independentes mostram que as alternativas abertas já ganham em custo e privacidade se você mesmo as roda, mas ainda ficam atrás do Jev em precisão quando a pergunta é nova para elas. É por isso que o Jev é o exemplo que vamos usar ao longo deste post.
Modelos de decisão vs. LLMs
Um modelo de linguagem de grande escala (LLM) como Claude, GPT ou Gemini gera a resposta um token de cada vez. Mesmo quando você só quer uma resposta de uma palavra, o LLM lê tudo, "escreve" a resposta e muitas vezes ainda se explica. Você paga por tudo isso e depois torce para que a resposta venha no formato que você pediu.
| LLM | Modelo de decisão | |
|---|---|---|
| Saída | Texto livre | Uma resposta entre as opções que você define |
| Consegue escrever ou raciocinar passo a passo? | Sim | Não |
| Resposta sempre no seu formato? | Geralmente, nem sempre | Sempre |
| Diz o quanto tem certeza? | Não de forma confiável | Sim, uma probabilidade calibrada |
| Custo | Paga por tokens de entrada e de saída | Geralmente só entrada, por uma fração do preço |
| Velocidade | Segundos para respostas mais longas | Normalmente bem menos de um segundo |
| Melhor em | Planejar, escrever, raciocínio aberto | Julgamentos rápidos, repetitivos e bem definidos |
Um não substitui o outro. A parte interessante é o que acontece quando você combina os dois, e é aí que entra o Kahneman.
Rápido e devagar: Sistema 1 e Sistema 2 para a IA
No livro Rápido e devagar: duas formas de pensar, de 2011, o psicólogo Daniel Kahneman descreve dois modos do pensamento humano:
- O Sistema 1 é rápido, automático e não exige esforço. Reconhecer o rosto de um amigo, ler uma placa de "Pare", saber que 2 + 2 = 4. Você não decide fazer isso; simplesmente acontece.
- O Sistema 2 é lento, deliberado e trabalhoso. Planejar uma viagem, comparar duas propostas de financiamento imobiliário, calcular 17 × 24. Ele exige atenção e energia, então você o usa com moderação.
A sacada principal é que quase tudo o que fazemos no dia a dia é Sistema 1. Só chamamos o Sistema 2 quando algo é novo, difícil ou surpreendente. Se você tivesse que pensar conscientemente em cada passo enquanto caminha, não sairia do lugar.
Os agentes de IA de hoje só têm Sistema 2
A maioria dos agentes de IA hoje usa um modelo de linguagem de grande escala para tudo. O LLM planeja a tarefa e depois o mesmo LLM decide cada clique, cada rolagem e cada tecla digitada. É como contratar um analista sênior para planejar um projeto e depois pedir que ele mesmo tire todas as fotocópias.
O resultado é previsível: agentes lentos, caros e que, de vez em quando, saem dos trilhos por causa de uma resposta mal formatada num passo que deveria ser trivial.
Modelos de decisão dão à IA um Sistema 1
Um modelo de decisão é o Sistema 1 que estava faltando: uma camada de julgamento rápida, barata e automática que cuida das decisões de rotina e sabe quando passar a bola.
Junte os dois e a arquitetura fica bem parecida com a mente humana:
- O Sistema 2 (o LLM) entende o que você pediu, faz o plano, escreve qualquer texto e lida com o que for fora do comum.
- O Sistema 1 (o modelo de decisão) toma as muitas decisões rápidas e repetitivas necessárias para executar o plano.
- A confiança é o sinal de passagem. Quando o modelo de decisão está confiante, o agente age. Quando não está, a pergunta sobe para o LLM, do mesmo jeito que uma pessoa passa a pensar com cuidado quando algo parece estranho.
Por que a automação de navegador é cara hoje
Para entender de onde vem a economia, veja o que um agente de IA no navegador realmente faz a cada passo:
- Ler a página. O agente captura o estado da página: um DOM simplificado, uma árvore de acessibilidade ou uma captura de tela.
- Decidir. O modelo lê esse estado, junto com o objetivo e o histórico dos passos anteriores, e escolhe a próxima ação.
- Agir. O agente clica, digita ou rola a página.
- Conferir. O modelo olha a nova página para ver se deu certo.
E aí repete tudo. A parte cara é o passo 2. O estado da página é grande, muitas vezes milhares de tokens por passo, e muitos agentes ainda reenviam o histórico cada vez maior da tarefa a cada passo. Análises do setor estimam uma tarefa típica de vários passos no navegador em 20.000 a 60.000 tokens, e o LLM ainda paga preço de saída para escrever cada ação.
O ponto é o seguinte: depois que a página vira uma lista de elementos candidatos, a maioria desses passos não é um problema de linguagem. São perguntas de múltipla escolha. "Em qual destes elementos devo clicar?" "A página mudou do jeito que esperávamos?" Isso é trabalho de Sistema 1, exatamente aquilo para o qual os modelos de decisão foram feitos.
Como os modelos de decisão reduzem em até 50 vezes o custo das ações no navegador
Para colocar números reais na economia, vamos comparar o Jev com o Claude Haiku 4.5, um dos LLMs mais em conta de um grande laboratório de IA. A TypeSafe chama o Jev de "System One model" (um "modelo Sistema 1"), usando diretamente o termo de Kahneman.
- Jev custa $0.042 por milhão de tokens de entrada, e a saída é de graça (no OpenRouter). As respostas normalmente chegam em 70 a 500 milissegundos.
- Claude Haiku 4.5 custa $1.00 por milhão de tokens de entrada e $5.00 por milhão de tokens de saída.
Pense em um único passo de rotina em uma tarefa no navegador, como escolher o elemento certo para clicar.
Usando um LLM (Claude Haiku 4.5) no passo: o agente envia cerca de 12.000 tokens de entrada (instruções, definições de ferramentas, estado da página e histórico da tarefa) e recebe cerca de 200 tokens de saída descrevendo a ação.
- Entrada: 12.000 × $1.00 / 1M = $0.0120
- Saída: 200 × $5.00 / 1M = $0.0010
- Total: cerca de $0.013 por passo
Usando um modelo de decisão (Jev) no mesmo passo: ele não precisa do histórico da conversa nem das definições de ferramentas. Ele recebe o objetivo deste passo e os elementos candidatos, uns 6.000 tokens de entrada, e devolve uma escolha com um nível de confiança. A saída é de graça.
- Entrada: 6.000 × $0.042 / 1M = $0.00025
- Saída: $0
- Total: cerca de $0.00025 por passo
Isso dá mais ou menos 50 vezes menos por passo de rotina, e a resposta normalmente volta em bem menos de um segundo.
O que isso significa para uma tarefa inteira
Uma tarefa real ainda precisa do Sistema 2 em algum momento: o LLM tem que entender o seu pedido e planejá-lo, e alguns passos vão ser genuinamente ambíguos. Então a economia em uma tarefa completa depende, acima de tudo, de uma coisa: com que frequência o modelo de decisão devolve um passo para o LLM.
Veja uma tarefa de 20 passos, usando os números por passo acima, com uma chamada de planejamento no Haiku (~$0.0075) na configuração híbrida:
| Configuração | Custo por tarefa | Custo para 1.000 tarefas | Economia vs. só LLM |
|---|---|---|---|
| LLM (Haiku) em todos os passos | $0.260 | $260 | referência |
| LLM planeja, modelo de decisão decide, 10% dos passos escalados | $0.039 | $39 | ~7x mais barato |
| LLM planeja, modelo de decisão decide, 0% escalados | $0.013 | $13 | ~20x mais barato |
| Só o modelo de decisão, em um fluxo repetido ou pré-planejado | $0.005 | $5 | ~50x mais barato |
Estimativas ilustrativas baseadas nos preços públicos de tabela. Os números reais dependem do tamanho da página, de quantos passos a tarefa leva, do cache de prompts e de quantas vezes a tarefa precisa do LLM.
O padrão é claro: quanto mais rotineira for a sua automação, mais perto você chega dos 50x. Fluxos repetitivos que você roda de novo e de novo, como preencher o mesmo formulário, conferir o mesmo painel ou fazer a triagem do mesmo tipo de página, são onde os modelos de decisão brilham.
Testes independentes apontam na mesma direção. Em um teste de roteamento com LiteLLM, 240 chamadas ao Jev custaram $0.0077, contra $0.1985 pelas mesmas chamadas no Claude Haiku 4.5, cerca de 26 vezes mais barato.
E mais rápido também
Custo não é a única vantagem. Um benchmark independente mediu o tempo de resposta mediano do Jev em 239 ms, contra 687 ms do Claude Haiku 4.5, cerca de 3 vezes mais rápido. Em uma tarefa de 20 passos, são vários segundos a menos esperando o navegador. O mesmo benchmark registrou zero saídas mal formatadas do modelo de decisão, já que ele só pode responder com uma das opções que recebeu.
Os modelos de decisão são precisos o suficiente?
Ser mais barato só importa se os cliques estiverem certos. Aqui vai a verdade.
Modelos de decisão se saem melhor em perguntas estreitas e bem definidas. Em um benchmark publicado de detecção de phishing, fazer ao Jev uma única pergunta ampla ("este e-mail é phishing?") resultou em 62,6% de precisão, contra 81,3% do Haiku. Mas quando a mesma tarefa foi dividida em cinco perguntas específicas, o modelo de decisão chegou a 95,0%, à frente dos 93,2% do Haiku.
É a lição do Sistema 1 de novo. O pensamento rápido é ótimo em julgamentos simples e específicos, e ruim nos complicados e vagos. Então o design certo divide o trabalho:
- Deixe o LLM quebrar a tarefa em decisões pequenas e concretas.
- Deixe o modelo de decisão responder cada decisão pequena, como "qual elemento?" ou "deu certo?"
- Use a confiança como rede de segurança. Respostas com pouca confiança voltam para o LLM em vez de virarem um chute.
Páginas da web são entradas não confiáveis. Pesquisadores de segurança da Check Point mostraram que modelos de decisão podem ser alvo de prompt injection, assim como os LLMs. Um espaço fixo de respostas limita o estrago (o modelo só pode escolher entre as opções que o seu código deu), mas não elimina o risco. Esse é mais um motivo para o SurfMind manter uma pessoa no circuito: as ações de navegador pedem a sua permissão antes de rodar.
Modelos de decisão no SurfMind: pensamento rápido e devagar no seu navegador
As ações de navegador do SurfMind deixam a IA clicar, digitar e rolar por você, direto nas páginas que você já está usando. Até agora, cada um desses passos passava por um modelo de linguagem.
Estamos adicionando um modelo de decisão como o Sistema 1 do SurfMind, começando pelo Jev:
- O LLM que você escolher é o Sistema 2. Ele entende o seu pedido, planeja a tarefa, escreve qualquer texto e entra em cena sempre que algo não está claro.
- O modelo de decisão é o Sistema 1. Ele cuida das decisões rotineiras e repetitivas: encontrar o elemento certo, confirmar que um passo funcionou, identificar pop-ups e banners.
- A confiança decide a passagem de bastão. Decisões confiantes seguem em frente. As incertas vão para o modelo completo, então você economiza sem abrir mão da confiabilidade.
- Você continua no controle. As ações de navegador continuam pedindo a sua permissão antes de rodar.
O objetivo é simples: a mesma automação de navegador que você usa hoje, por uma fração do custo, e potencialmente até 50 vezes menos do que rodar cada passo só no Claude Haiku. Isso combina com o jeito como o SurfMind sempre funcionou: pague só pelo que usar e escolha o modelo certo para cada tarefa, em vez de pagar preço premium por tudo.
Quer uma IA que trabalha no seu navegador sem pesar no bolso?
O SurfMind leva mais de 300 modelos de IA e ações de navegador para cada página que você visita e, com os modelos de decisão, os cliques de rotina ficam muito mais baratos.
Posts relacionados
Ver tudo
Significado de BYOK: o que é Bring Your Own Key e por que é o futuro das ferramentas de IA
BYOK significa Bring Your Own Key: você conecta sua própria chave API às ferramentas de IA em vez de pagar assinaturas. Veja como economizar 40–90% e começar em 5 minutos.
Os melhores modelos gratuitos do OpenRouter em 2026 (e como realmente usá-los)
O OpenRouter reúne modelos grátis da NVIDIA, Google, OpenAI e mais. Veja quais valem a pena, os limites reais e como conversar com eles no navegador.
5 maneiras de ter IA com qualidade Claude/GPT por menos de US$ 5 por mês
Esqueça as assinaturas de US$ 20 por mês. Veja como acessar modelos de ponta como Claude Sonnet 4.6, GPT-5.4 e Gemini 3 Flash por uma fração do custo, usando BYOK e uma boa seleção de modelos.