
 Добавить в Chrome
Что такое ИИ-модель принятия решений? Как Jev делает автоматизацию браузера в 50 раз дешевле
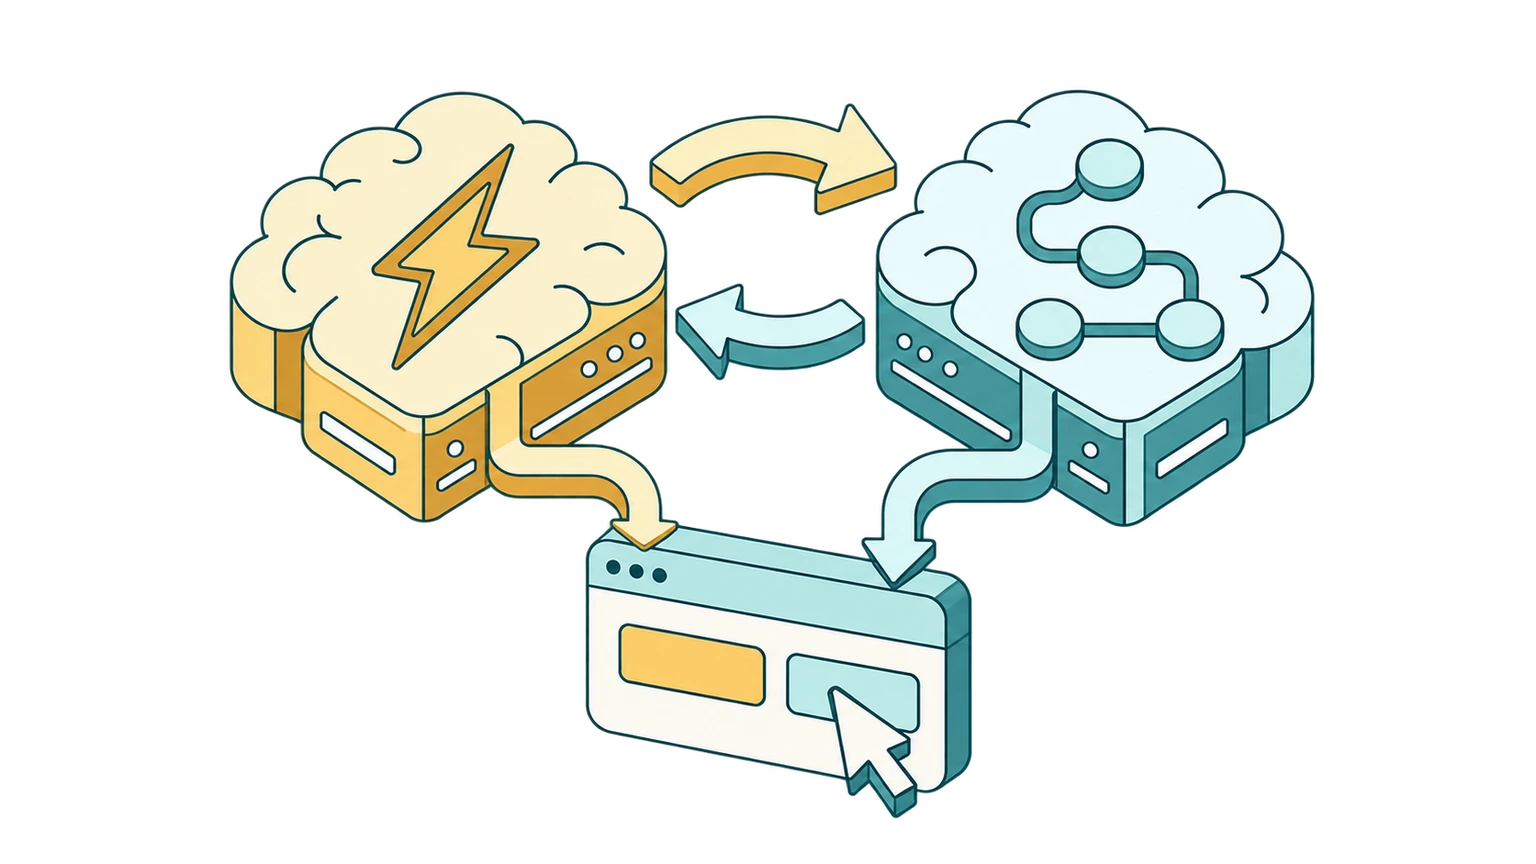
Прежде чем ИИ-агент в браузере что-то нажмёт, ему нужно понять, что именно нажимать. Поэтому он отправляет страницу языковой модели и спрашивает: «Что делать дальше?» Модель читает страницу целиком, обдумывает её и пишет ответ. И только потом агент кликает.
За каждый токен в этом обмене вы платите. Один клик — это доли цента. Но задача из 20 шагов, которую вы запускаете каждый день, быстро превращается в ощутимую сумму.
И вот что забавно: большинство этих вопросов — простые. «Какая из этих кнопок — „Добавить в корзину“?» «Форма отправилась?» «Это баннер про cookie?» Вы ответили бы на них за долю секунды, почти не задумываясь. А большинство ИИ-агентов отвечают на них долгим и дорогим способом: каждый раз просят полноценную языковую модель написать развёрнутый ответ.
Для такой работы есть инструмент получше — ИИ-модель принятия решений. Сама идея существует давно, но в сентябре 2026 года внимания к ней стало куда больше: TypeSafe AI выпустила Jev — модель принятия решений, которая работает быстро, почти ничего не стоит и справляется практически с любым вопросом, который вы ей подкинете. В этой статье разберём, что такое модели принятия решений, почему книга Даниэля Канемана «Думай медленно… решай быстро» — лучший способ их понять и как разделение работы между «быстрыми» и «медленными» моделями делает автоматизацию браузера до 50 раз дешевле, чем прогон каждого шага через небольшую LLM вроде Claude Haiku. Именно это мы сейчас внедряем в браузерные действия SurfMind.
Что такое ИИ-модель принятия решений?
ИИ-модель принятия решений принимает решения. И всё. Она не пишет текст.
Вы даёте ей ситуацию (например, веб-страницу) и вопрос с фиксированным набором вариантов ответа: «Какой из этих 14 элементов — кнопка оформления заказа?» или «Закрыта ли эта страница формой входа?» Модель выбирает один из ваших вариантов и сообщает, насколько она уверена. Никаких абзацев, никаких пояснений, ничего не нужно потом вычищать.
Поэтому внутри программ она оказывается на удивление полезной — по двум причинам:
- Ответ всегда подходит. Модель может выбрать только из предложенных вами вариантов, так что код сразу может действовать по результату.
- Она знает, насколько уверена. Хорошая модель принятия решений откалибрована: если она говорит «90%», то права примерно в 90% случаев. По этой уверенности агент понимает, когда действовать самому, а когда звать на помощь.
Jev — хороший пример. Модель не пишет ни слова, отвечает заметно быстрее, чем за секунду, и стоит лишь малую долю того, во что обходится LLM. Чуть ниже мы посчитаем экономию по её опубликованным ценам.
Модели принятия решений — не новинка
Идея отдельной модели, которая только выносит суждения, существует уже несколько лет и встречается в разных формах:
- Дообученные классификаторы — например, модели на базе BERT (с 2018 года) — быстрые и точные, но каждая умеет только одно. Спам-фильтр распознаёт спам, и на этом всё.
- Zero-shot-классификаторы, такие как модели логического вывода на естественном языке (NLI) и более новые открытые модели вроде GLiClass, позволяют придумывать метки прямо в момент запроса, без всякого обучения.
- Модели вознаграждения и классификаторы безопасности, например Llama Guard от Meta, работают рядом с другими ИИ-моделями и оценивают то, что те выдают.
- Небольшие LLM в роли классификаторов не пишут ответ, а просто считывают, насколько вероятен каждый вариант. Так устроены открытые проекты вроде OpenJev.
Почему же выстрелил именно Jev? Он объединяет все эти идеи в одной облачной модели, которая справляется почти с любым вопросом, сформулированным обычным языком, выдаёт откалиброванную уверенность и по цене рассчитана на решения, которые принимаются миллионы раз в день. Независимые сравнения показывают: открытые альтернативы уже выигрывают по стоимости и приватности, если запускать их у себя, но всё ещё уступают Jev в точности, когда вопрос для них новый. Поэтому в этой статье мы везде берём в пример Jev.
Модели принятия решений и LLM
Большая языковая модель (LLM) — Claude, GPT или Gemini — генерирует ответ по одному токену. Даже если вам нужен ответ из одного слова, LLM читает всё, «пишет» ответ и нередко ещё и объясняет его. Вы платите за всё это, а потом надеетесь, что ответ пришёл в нужном формате.
| LLM | Модель принятия решений | |
|---|---|---|
| Результат | Произвольный текст | Один ответ из заданных вами вариантов |
| Умеет писать и рассуждать пошагово? | Да | Нет |
| Ответ всегда в вашем формате? | Обычно, но не всегда | Всегда |
| Сообщает, насколько уверена? | Ненадёжно | Да, откалиброванную вероятность |
| Стоимость | Оплата входных и выходных токенов | Обычно только входных, и в разы дешевле |
| Скорость | Секунды на длинные ответы | Как правило, заметно меньше секунды |
| Сильная сторона | Планирование, тексты, открытые рассуждения | Быстрые, повторяющиеся, чётко заданные суждения |
Ни одна не заменяет другую. Самое интересное начинается, когда их объединяют, — и тут на сцену выходит Канеман.
«Думай медленно… решай быстро»: Система 1 и Система 2 для ИИ
В книге «Думай медленно… решай быстро» (2011) психолог Даниэль Канеман описывает два режима человеческого мышления:
- Система 1 — быстрая, автоматическая, не требующая усилий. Узнать лицо друга, прочитать знак «Стоп», знать, что 2 + 2 = 4. Вы не решаете это делать — оно просто происходит.
- Система 2 — медленная, обдуманная, требующая усилий. Спланировать поездку, сравнить два ипотечных предложения, посчитать 17 × 24. На это уходят внимание и силы, поэтому пользуемся мы ею экономно.
Ключевой вывод: почти всё, что мы делаем за день, — это Система 1. Систему 2 мы подключаем, только когда сталкиваемся с чем-то новым, сложным или неожиданным. Если бы вам приходилось сознательно обдумывать каждый шаг при ходьбе, вы бы никуда не дошли.
У современных ИИ-агентов есть только Система 2
Большинство ИИ-агентов сегодня используют большую языковую модель для всего подряд. LLM планирует задачу, а затем та же LLM решает, куда кликнуть, что прокрутить и какую клавишу нажать, — на каждом шаге. Это как нанять старшего аналитика, чтобы он спланировал проект, а потом попросить его лично делать ещё и все ксерокопии.
Результат предсказуем: агенты медленные, дорогие и иногда сбиваются из-за кривого ответа на шаге, который должен был быть элементарным.
Модели принятия решений дают ИИ Систему 1
Модель принятия решений — это недостающая Система 1: быстрый, дешёвый, автоматический слой суждений, который берёт на себя рутину и понимает, когда пора передать задачу дальше.
Соедините их — и архитектура станет очень похожа на человеческое мышление:
- Система 2 (LLM) понимает, что вы попросили, составляет план, пишет тексты и разбирается со всем необычным.
- Система 1 (модель принятия решений) принимает множество быстрых однотипных решений, нужных для выполнения плана.
- Уверенность — сигнал для передачи. Если модель принятия решений уверена, агент действует. Если нет — вопрос уходит к LLM, точно так же, как человек переключается на вдумчивое мышление, когда что-то кажется странным.
Почему автоматизация браузера сегодня стоит дорого
Чтобы понять, откуда берётся экономия, посмотрим, что ИИ-агент в браузере делает на каждом шаге:
- Читает страницу. Агент фиксирует состояние страницы: упрощённый DOM, дерево доступности или скриншот.
- Принимает решение. Модель читает это состояние, а также цель и историю предыдущих шагов, и выбирает следующее действие.
- Действует. Агент кликает, вводит текст или прокручивает страницу.
- Проверяет. Модель смотрит на новую страницу, чтобы понять, сработало ли.
И так по кругу. Дорогая часть — шаг 2. Состояние страницы занимает много места, часто тысячи токенов на шаг, а многие агенты к тому же на каждом шаге заново отправляют растущую историю задачи. По отраслевым оценкам, типичная многошаговая задача в браузере съедает от 20 000 до 60 000 токенов, а LLM вдобавок платит по тарифу выходных токенов за описание каждого действия.
И вот в чём дело: когда страница уже превращена в список элементов-кандидатов, большинство этих шагов — вовсе не языковые задачи. Это вопросы с вариантами ответа. «Какой из этих элементов нажать?» «Изменилась ли страница так, как мы ожидали?» Это работа для Системы 1 — ровно то, для чего созданы модели принятия решений.
Как модели принятия решений удешевляют браузерные действия до 50 раз
Чтобы подкрепить экономию реальными цифрами, сравним Jev с Claude Haiku 4.5 — одной из самых доступных LLM от крупной ИИ-лаборатории. TypeSafe называет Jev «System One model» («моделью Системы 1»), напрямую заимствуя термин Канемана.
- Jev стоит $0.042 за миллион входных токенов, а выходные бесплатны (на OpenRouter). Ответ обычно приходит за 70–500 миллисекунд.
- Claude Haiku 4.5 стоит $1.00 за миллион входных токенов и $5.00 за миллион выходных.
Возьмём один рутинный шаг браузерной задачи — например, выбор нужного элемента для клика.
Если шаг выполняет LLM (Claude Haiku 4.5): агент отправляет около 12 000 входных токенов (инструкции, описания инструментов, состояние страницы и историю задачи) и получает около 200 выходных токенов с описанием действия.
- Вход: 12 000 × $1.00 / 1M = $0.0120
- Выход: 200 × $5.00 / 1M = $0.0010
- Итого: около $0.013 за шаг
Если тот же шаг выполняет модель принятия решений (Jev): ей не нужны ни история чата, ни описания инструментов. Она получает цель текущего шага и элементы-кандидаты — около 6000 входных токенов — и возвращает выбор с уровнем уверенности. Выход бесплатный.
- Вход: 6000 × $0.042 / 1M = $0.00025
- Выход: $0
- Итого: около $0.00025 за шаг
Это примерно в 50 раз дешевле на каждом рутинном шаге, и ответ, как правило, приходит заметно быстрее, чем за секунду.
Что это значит для задачи целиком
Реальной задаче всё равно где-то нужна Система 2: LLM должна понять ваш запрос и спланировать его, а некоторые шаги действительно будут неоднозначными. Поэтому экономия на полной задаче зависит прежде всего от одного: как часто модель принятия решений возвращает шаг обратно LLM.
Вот задача из 20 шагов с теми же цифрами в расчёте на шаг и одним вызовом Haiku для планирования (~$0.0075) в гибридной схеме:
| Схема | Стоимость задачи | Стоимость 1000 задач | Экономия относительно «только LLM» |
|---|---|---|---|
| LLM (Haiku) на каждом шаге | $0.260 | $260 | базовый уровень |
| LLM планирует, модель принятия решений решает, 10% шагов передаются LLM | $0.039 | $39 | ~в 7 раз дешевле |
| LLM планирует, модель принятия решений решает, 0% передаётся LLM | $0.013 | $13 | ~в 20 раз дешевле |
| Только модель принятия решений, повторяющийся или заранее спланированный сценарий | $0.005 | $5 | ~в 50 раз дешевле |
Ориентировочные оценки по публичным прайс-листам. Реальные цифры зависят от размера страницы, числа шагов в задаче, кеширования промптов и того, как часто задаче нужна LLM.
Закономерность очевидна: чем больше в вашей автоматизации рутины, тем ближе вы к экономии в 50 раз. Повторяющиеся сценарии, которые вы запускаете снова и снова — заполнение одной и той же формы, проверка одного и того же дашборда, разбор однотипных страниц, — это как раз то, где модели принятия решений раскрываются в полной мере.
Независимые тесты говорят о том же. В одном тесте маршрутизации через LiteLLM 240 вызовов Jev обошлись в $0.0077 против $0.1985 за те же вызовы на Claude Haiku 4.5 — примерно в 26 раз дешевле.
И быстрее тоже
Дело не только в деньгах. Независимый бенчмарк показал медианное время ответа Jev 239 мс против 687 мс у Claude Haiku 4.5 — примерно в 3 раза быстрее. На задаче из 20 шагов это многие секунды, которые вы не потратите на ожидание браузера. Тот же бенчмарк не зафиксировал у модели принятия решений ни одного некорректного ответа — ведь она может ответить только одним из предложенных вариантов.
Достаточно ли точны модели принятия решений?
Дешевизна имеет смысл, только если клики правильные. Вот честный расклад.
Модели принятия решений лучше всего справляются с узкими, чётко сформулированными вопросами. В опубликованном бенчмарке по распознаванию фишинга один общий вопрос к Jev («это фишинговое письмо?») дал точность 62,6% против 81,3% у Haiku. Но когда ту же задачу разбили на пять узких вопросов, модель принятия решений достигла 95,0% и обошла Haiku с его 93,2%.
Это снова урок Системы 1. Быстрое мышление отлично справляется с простыми и конкретными суждениями и плохо — со сложными и расплывчатыми. Поэтому правильная архитектура делит работу:
- Пусть LLM разбивает задачу на небольшие конкретные решения.
- Пусть модель принятия решений отвечает на каждое из них — например, «какой элемент?» или «сработало ли?».
- Используйте уверенность как страховку. Ответы с низкой уверенностью возвращаются к LLM, а не выдаются наугад.
Веб-страницы — недоверенный ввод. Исследователи безопасности из Check Point показали, что модели принятия решений уязвимы для промпт-инъекций так же, как LLM. Фиксированный набор ответов ограничивает ущерб (модель может выбрать только из вариантов, которые дал ваш код), но не устраняет риск полностью. Это ещё одна причина, по которой SurfMind оставляет человека в контуре: браузерные действия запрашивают ваше разрешение перед запуском.
Модели принятия решений в SurfMind: быстрое и медленное мышление в вашем браузере
Браузерные действия SurfMind позволяют ИИ кликать, вводить текст и прокручивать страницы за вас — прямо на тех сайтах, которыми вы уже пользуетесь. До сих пор каждый такой шаг проходил через языковую модель.
Теперь мы добавляем в SurfMind модель принятия решений в роли Системы 1 и начинаем с Jev:
- Выбранная вами LLM — это Система 2. Она понимает ваш запрос, планирует задачу, пишет тексты и подключается всякий раз, когда что-то неясно.
- Модель принятия решений — это Система 1. Она берёт на себя рутинные, повторяющиеся решения: найти нужный элемент, убедиться, что шаг сработал, заметить всплывающие окна и баннеры.
- Уверенность определяет передачу. Уверенные решения выполняются сразу. Неуверенные уходят к полноценной модели — так вы экономите, не жертвуя надёжностью.
- Контроль остаётся за вами. Браузерные действия по-прежнему запрашивают ваше разрешение перед запуском.
Цель простая: та же автоматизация браузера, которой вы пользуетесь сегодня, но за малую долю прежней цены — потенциально до 50 раз дешевле, чем если прогонять каждый шаг только через Claude Haiku. Это вписывается в то, как SurfMind работал всегда: оплата только за то, что вы используете, и подбор модели под задачу вместо премиальных цен за всё подряд.
Хотите ИИ, который работает в вашем браузере и не опустошает кошелёк?
SurfMind открывает доступ к 300+ ИИ-моделям и браузерным действиям на любой странице, а с моделями принятия решений рутинные клики становятся в разы дешевле.
Похожие публикации
Смотреть все
Что означает BYOK: как работает Bring Your Own Key в ИИ-инструментах
BYOK означает Bring Your Own Key: вы подключаете собственный API-ключ к ИИ-инструментам вместо оплаты подписок. Узнайте, как сэкономить 40–90% и начать за 5 минут.
Лучшие бесплатные модели OpenRouter в 2026 году (и как ими действительно пользоваться)
OpenRouter предлагает бесплатные модели NVIDIA, Google, OpenAI и других компаний. Разбираем достойные варианты, реальные лимиты и работу с ними в браузере.
5 способов получить ИИ качества Claude/GPT менее чем за $5 в месяц
Обойдитесь без подписок за $20 в месяц. Узнайте, как пользоваться топовыми нейросетями вроде Claude Sonnet 4.6, GPT-5.4 и Gemini 3 Flash в разы дешевле благодаря BYOK и грамотному выбору моделей.