
 Thêm vào Chrome
Mô hình quyết định AI là gì? Cách Jev giúp tự động hóa trình duyệt rẻ hơn 50 lần
Trước khi một AI agent trên trình duyệt click vào bất cứ thứ gì, nó phải biết nên click vào đâu. Vậy là nó gửi cả trang web cho một mô hình ngôn ngữ và hỏi: "Bước tiếp theo nên làm gì?" Mô hình đọc hết trang, suy nghĩ một hồi, rồi viết ra câu trả lời. Xong xuôi agent mới click.
Mỗi token trong vòng hỏi đáp đó đều bị tính tiền. Với một cú click thì chỉ tốn chưa tới một cent. Nhưng với một tác vụ 20 bước mà ngày nào bạn cũng chạy, con số ấy cộng dồn nhanh lắm.
Mà buồn cười ở chỗ: phần lớn những câu hỏi đó đều dễ ợt. "Nút nào trong mấy nút này là 'Thêm vào giỏ hàng'?" "Form đã gửi đi chưa?" "Cái này có phải banner cookie không?" Bạn trả lời mấy câu này trong nháy mắt, gần như chẳng cần nghĩ. Vậy mà đa số AI agent lại trả lời theo cách chậm và tốn kém: lần nào cũng nhờ một mô hình ngôn ngữ hoàn chỉnh viết ra câu trả lời.
Có một công cụ hợp với việc này hơn nhiều: mô hình quyết định AI (AI decision model). Ý tưởng này đã có từ lâu, nhưng chỉ thực sự được chú ý vào tháng 9/2026, khi TypeSafe AI ra mắt Jev, một mô hình quyết định vừa nhanh, vừa gần như chẳng tốn đồng nào để chạy, lại xử lý được gần như mọi câu hỏi bạn đưa ra. Trong bài này, chúng ta sẽ tìm hiểu mô hình quyết định là gì, vì sao cuốn Tư duy nhanh và chậm của Daniel Kahneman là cách dễ hiểu nhất để nắm được chúng, và vì sao chia việc giữa mô hình "nhanh" và mô hình "chậm" có thể giúp tự động hóa trình duyệt rẻ hơn tới 50 lần so với việc chạy mọi bước qua một LLM nhỏ như Claude Haiku. Đây cũng chính là thứ chúng tôi đang đưa vào tính năng thao tác trình duyệt (browser actions) của SurfMind.
Mô hình quyết định AI là gì?
Một mô hình quyết định AI chỉ làm đúng một việc: ra quyết định. Hết. Nó không viết.
Bạn đưa cho nó một tình huống (ví dụ một trang web) và một câu hỏi kèm sẵn danh sách đáp án cố định: "Trong 14 phần tử này, cái nào là nút thanh toán?" hoặc "Trang này có bị chặn bởi màn hình đăng nhập không?" Nó chọn một trong các đáp án của bạn và cho biết nó chắc chắn đến mức nào. Không có đoạn văn dài dòng, không giải thích, không có gì phải dọn dẹp sau đó.
Nhờ vậy, nó hữu ích đến bất ngờ khi dùng bên trong phần mềm, vì hai lý do:
- Câu trả lời luôn đúng định dạng. Nó chỉ được chọn trong các lựa chọn bạn đưa ra, nên code của bạn có thể dùng ngay kết quả.
- Nó biết mình chắc chắn đến đâu. Một mô hình quyết định tốt được hiệu chỉnh (calibrated): khi nó nói 90% thì nó đúng khoảng 90% số lần. Độ tin cậy này cho agent biết lúc nào cứ thế làm, lúc nào nên nhờ trợ giúp.
Jev là một ví dụ điển hình. Nó không bao giờ viết ra chữ nào, trả lời trong chưa đầy một giây và chi phí chỉ bằng một phần rất nhỏ so với LLM. Lát nữa chúng ta sẽ dùng bảng giá công khai của nó để tính xem tiết kiệm được bao nhiêu.
Mô hình quyết định không phải thứ gì mới
Ý tưởng về một mô hình riêng chỉ chuyên đưa ra phán đoán đã xuất hiện từ nhiều năm nay, dưới vài hình thức khác nhau:
- Bộ phân loại được fine-tune như các mô hình dựa trên BERT (từ năm 2018) vừa nhanh vừa chính xác, nhưng mỗi mô hình chỉ biết làm một việc. Bộ lọc spam thì phát hiện spam, vậy thôi.
- Bộ phân loại zero-shot, chẳng hạn các mô hình suy luận ngôn ngữ tự nhiên (NLI) và những mô hình mở mới hơn như GLiClass, cho phép bạn tự đặt nhãn ngay lúc hỏi, không cần huấn luyện.
- Reward model và bộ phân loại an toàn, như Llama Guard của Meta, đứng cạnh các mô hình AI khác và đánh giá những gì chúng tạo ra.
- LLM nhỏ dùng làm bộ phân loại bỏ qua bước viết câu trả lời, chỉ đọc xác suất của từng phương án. Các dự án mở như OpenJev hoạt động theo cách này.
Vậy tại sao Jev lại nổi lên? Nó gom tất cả những ý tưởng trên vào một mô hình được host sẵn, xử lý gần như mọi câu hỏi bạn mô tả bằng tiếng Anh thông thường, trả về độ tin cậy đã được hiệu chỉnh, và có mức giá dành cho những quyết định diễn ra hàng triệu lần mỗi ngày. Các so sánh độc lập cho thấy các lựa chọn mã nguồn mở đã thắng về chi phí và quyền riêng tư nếu bạn tự chạy, nhưng vẫn thua Jev về độ chính xác khi gặp câu hỏi mới. Đó là lý do chúng tôi dùng Jev làm ví dụ xuyên suốt bài viết này.
Mô hình quyết định vs. LLM
Một mô hình ngôn ngữ lớn (LLM) như Claude, GPT hay Gemini tạo câu trả lời từng token một. Ngay cả khi bạn chỉ cần câu trả lời một chữ, LLM vẫn đọc tất cả, "viết" ra phản hồi và thường còn giải thích thêm. Bạn trả tiền cho toàn bộ chỗ đó, rồi cầu mong câu trả lời đúng định dạng bạn yêu cầu.
| LLM | Mô hình quyết định | |
|---|---|---|
| Đầu ra | Văn bản tự do | Một đáp án trong các lựa chọn bạn định nghĩa |
| Có viết hoặc suy luận từng bước được không? | Có | Không |
| Câu trả lời luôn đúng định dạng? | Thường là có, nhưng không phải lúc nào cũng vậy | Luôn luôn |
| Có cho biết độ chắc chắn không? | Không đáng tin cậy | Có, dưới dạng xác suất đã hiệu chỉnh |
| Chi phí | Trả tiền cho cả token đầu vào lẫn đầu ra | Thường chỉ tính đầu vào, với giá chỉ bằng một phần nhỏ |
| Tốc độ | Vài giây với câu trả lời dài | Thường chưa đầy một giây |
| Giỏi nhất ở | Lập kế hoạch, viết, suy luận mở | Những phán đoán nhanh, lặp lại, được xác định rõ |
Không bên nào thay thế được bên nào. Điều thú vị nằm ở chỗ khi bạn kết hợp cả hai, và đó là lúc Kahneman xuất hiện.
Tư duy nhanh và chậm: Hệ thống 1 và Hệ thống 2 cho AI
Trong cuốn sách Tư duy nhanh và chậm xuất bản năm 2011, nhà tâm lý học Daniel Kahneman mô tả hai chế độ tư duy của con người:
- Hệ thống 1 nhanh, tự động và không tốn sức. Nhận ra gương mặt một người bạn, đọc biển báo dừng, biết rằng 2 + 2 = 4. Bạn không quyết định làm điều đó; nó cứ tự xảy ra.
- Hệ thống 2 chậm, có chủ đích và tốn sức. Lên kế hoạch cho một chuyến đi, so sánh hai gói vay mua nhà, tính 17 × 24. Nó đòi hỏi sự tập trung và năng lượng, nên bạn dùng nó một cách dè sẻn.
Điểm mấu chốt là phần lớn những gì ta làm mỗi ngày đều thuộc về Hệ thống 1. Ta chỉ gọi Hệ thống 2 ra khi gặp điều gì mới, khó hoặc bất ngờ. Nếu phải cân nhắc có ý thức từng bước chân khi đi bộ, bạn sẽ chẳng bao giờ đi tới đâu.
AI agent ngày nay chỉ có Hệ thống 2
Hầu hết AI agent hiện nay dùng một mô hình ngôn ngữ lớn cho mọi thứ. LLM lên kế hoạch cho tác vụ, rồi cũng chính LLM đó quyết định từng cú click, từng lần cuộn trang, từng phím gõ. Giống như thuê một chuyên viên phân tích cấp cao để lập kế hoạch dự án, rồi bắt họ tự tay đi photo từng tờ giấy vậy.
Kết quả thì dễ đoán: các agent chậm, tốn kém, và thỉnh thoảng lại "trật đường ray" chỉ vì một câu trả lời sai định dạng ở một bước lẽ ra rất đơn giản.
Mô hình quyết định trao cho AI một Hệ thống 1
Mô hình quyết định chính là mảnh ghép Hệ thống 1 còn thiếu: một lớp phán đoán nhanh, rẻ, tự động, xử lý những quyết định thường ngày và biết lúc nào nên chuyển giao.
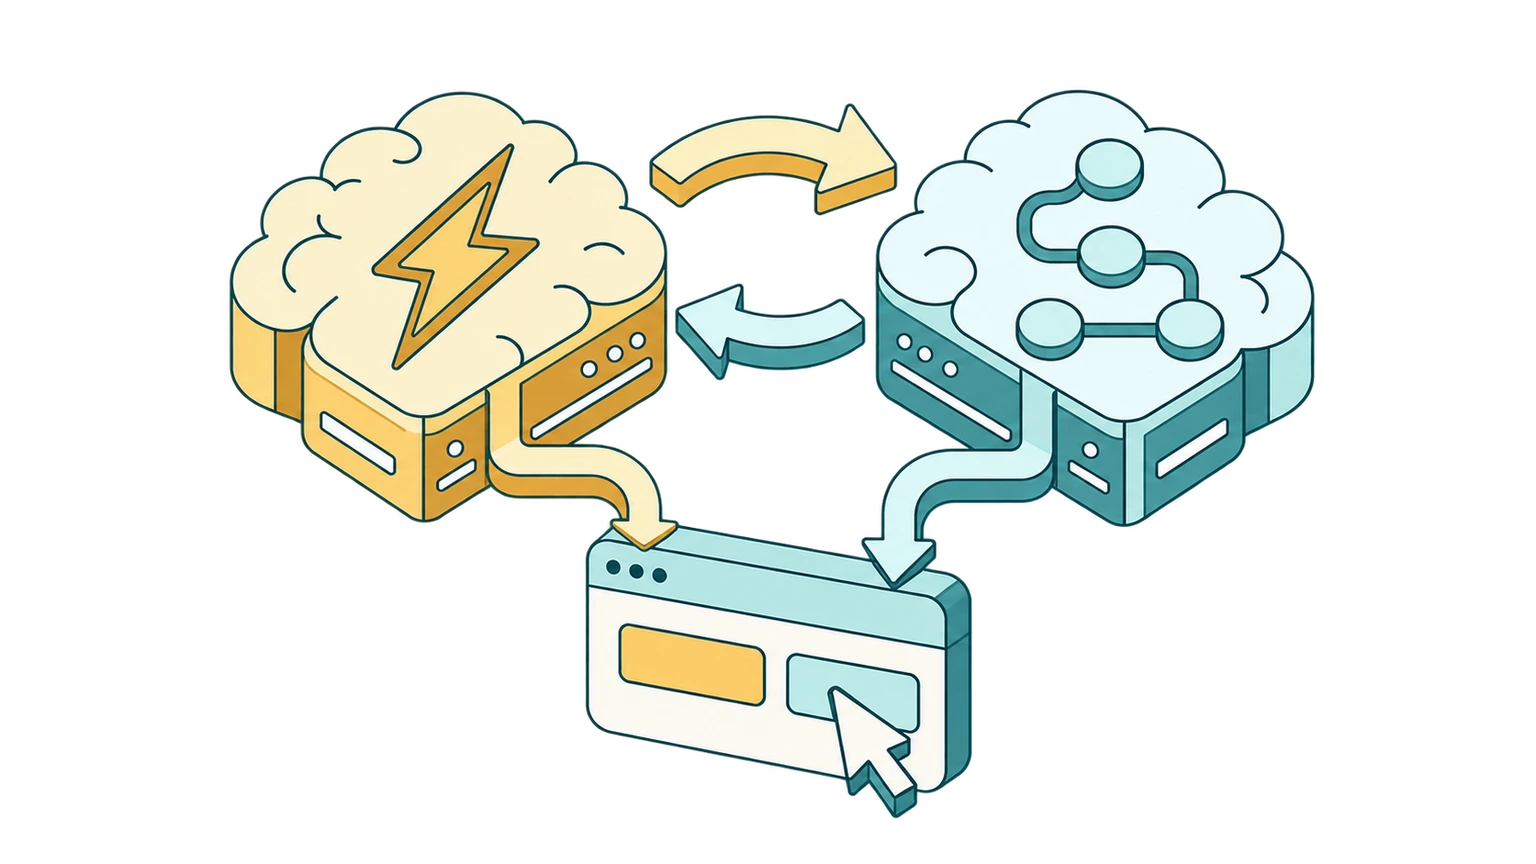
Ghép hai thứ lại với nhau, kiến trúc này trông rất giống tâm trí con người:
- Hệ thống 2 (LLM) hiểu bạn đang yêu cầu gì, lập kế hoạch, viết bất kỳ văn bản nào cần viết và xử lý mọi tình huống bất thường.
- Hệ thống 1 (mô hình quyết định) đưa ra vô số quyết định nhanh, lặp đi lặp lại cần thiết để thực hiện kế hoạch.
- Độ tin cậy là tín hiệu chuyển giao. Khi mô hình quyết định chắc chắn, agent hành động. Khi không chắc, câu hỏi được chuyển lên LLM, giống như con người chuyển sang suy nghĩ cẩn thận khi thấy có gì đó sai sai.
Vì sao tự động hóa trình duyệt hiện nay lại tốn kém
Để thấy khoản tiết kiệm đến từ đâu, hãy xem một AI agent trên trình duyệt thực sự làm gì ở mỗi bước:
- Đọc trang. Agent ghi lại trạng thái trang: một DOM rút gọn, cây accessibility hoặc ảnh chụp màn hình.
- Quyết định. Mô hình đọc trạng thái đó, cộng với mục tiêu và lịch sử các bước trước, rồi chọn hành động tiếp theo.
- Hành động. Agent click, gõ phím hoặc cuộn trang.
- Kiểm tra. Mô hình xem trang mới để biết thao tác có thành công không.
Rồi lặp lại. Phần tốn kém là bước 2. Trạng thái trang rất lớn, thường lên tới hàng nghìn token mỗi bước, và nhiều agent còn gửi lại toàn bộ lịch sử tác vụ (ngày càng dài ra) ở mỗi bước. Các bài phân tích trong ngành ước tính một tác vụ trình duyệt nhiều bước thông thường tốn 20,000 đến 60,000 token, và LLM còn phải trả thêm giá token đầu ra để viết ra từng hành động.
Vấn đề là thế này: một khi trang đã được chuyển thành danh sách các phần tử ứng viên, phần lớn các bước đó không phải bài toán ngôn ngữ. Chúng là câu hỏi trắc nghiệm. "Nên click vào phần tử nào trong số này?" "Trang có thay đổi đúng như mong đợi không?" Đó là việc của Hệ thống 1, đúng thứ mà mô hình quyết định được sinh ra để làm.
Mô hình quyết định cắt giảm chi phí thao tác trình duyệt tới 50 lần như thế nào
Để có con số cụ thể, chúng ta sẽ so sánh Jev với Claude Haiku 4.5, một trong những LLM rẻ nhất của các phòng lab AI lớn. TypeSafe gọi Jev là một "System One model" (mô hình Hệ thống 1), dùng thẳng thuật ngữ của Kahneman.
- Jev có giá $0.042 cho mỗi triệu token đầu vào, còn đầu ra thì miễn phí (trên OpenRouter). Câu trả lời thường có sau 70 đến 500 mili giây.
- Claude Haiku 4.5 có giá $1.00 cho mỗi triệu token đầu vào và $5.00 cho mỗi triệu token đầu ra.
Lấy một bước thường gặp trong tác vụ trình duyệt, chẳng hạn chọn đúng phần tử để click.
Dùng LLM (Claude Haiku 4.5) cho bước này: agent gửi khoảng 12,000 token đầu vào (chỉ dẫn, định nghĩa tool, trạng thái trang và lịch sử tác vụ) và nhận về khoảng 200 token đầu ra mô tả hành động.
- Đầu vào: 12,000 × $1.00 / 1M = $0.0120
- Đầu ra: 200 × $5.00 / 1M = $0.0010
- Tổng: khoảng $0.013 mỗi bước
Dùng mô hình quyết định (Jev) cho cùng bước đó: nó không cần lịch sử chat hay định nghĩa tool. Nó chỉ nhận mục tiêu của bước này và các phần tử ứng viên, khoảng 6,000 token đầu vào, rồi trả về một lựa chọn kèm độ tin cậy. Đầu ra miễn phí.
- Đầu vào: 6,000 × $0.042 / 1M = $0.00025
- Đầu ra: $0
- Tổng: khoảng $0.00025 mỗi bước
Tức là rẻ hơn khoảng 50 lần cho mỗi bước thường gặp, và câu trả lời thường về chưa đầy một giây.
Tính trên cả một tác vụ thì sao
Một tác vụ thực tế vẫn cần Hệ thống 2 ở đâu đó: LLM phải hiểu yêu cầu của bạn và lập kế hoạch, và sẽ có những bước thực sự mơ hồ. Vì vậy, mức tiết kiệm trên cả tác vụ phụ thuộc chủ yếu vào một yếu tố: mô hình quyết định phải trả bước về cho LLM thường xuyên đến mức nào.
Dưới đây là một tác vụ 20 bước, dùng chi phí mỗi bước ở trên, với một lần gọi Haiku để lập kế hoạch (~$0.0075) trong cấu hình kết hợp:
| Cấu hình | Chi phí mỗi tác vụ | Chi phí cho 1,000 tác vụ | Tiết kiệm so với chỉ dùng LLM |
|---|---|---|---|
| LLM (Haiku) cho mọi bước | $0.260 | $260 | mốc so sánh |
| LLM lập kế hoạch, mô hình quyết định ra quyết định, 10% số bước được chuyển lên LLM | $0.039 | $39 | rẻ hơn ~7 lần |
| LLM lập kế hoạch, mô hình quyết định ra quyết định, 0% chuyển lên | $0.013 | $13 | rẻ hơn ~20 lần |
| Chỉ dùng mô hình quyết định, trên workflow lặp lại hoặc đã lên kế hoạch sẵn | $0.005 | $5 | rẻ hơn ~50 lần |
Ước tính minh họa dựa trên bảng giá công khai. Con số thực tế phụ thuộc vào kích thước trang, số bước của tác vụ, prompt caching và tần suất tác vụ cần đến LLM.
Quy luật rất rõ: tự động hóa của bạn càng nhiều phần thường lệ thì càng tiến gần mức 50 lần. Những workflow bạn chạy đi chạy lại, như điền cùng một form, kiểm tra cùng một dashboard hay phân loại cùng một kiểu trang, chính là nơi mô hình quyết định tỏa sáng.
Các bài test độc lập cũng cho kết quả tương tự. Trong một bài test định tuyến bằng LiteLLM, 240 lần gọi Jev tốn $0.0077, so với $0.1985 cho cùng số lần gọi trên Claude Haiku 4.5, tức rẻ hơn khoảng 26 lần.
Nhanh hơn nữa
Chi phí không phải lợi ích duy nhất. Một benchmark độc lập đo được thời gian phản hồi trung vị của Jev là 239 ms, so với 687 ms của Claude Haiku 4.5, tức nhanh hơn khoảng 3 lần. Qua một tác vụ 20 bước, bạn đỡ phải ngồi chờ trình duyệt được kha khá giây. Cũng benchmark đó ghi nhận mô hình quyết định không trả về đầu ra sai định dạng nào, vì nó chỉ có thể trả lời bằng một trong các lựa chọn được đưa ra.
Mô hình quyết định có đủ chính xác không?
Rẻ hơn chỉ có ý nghĩa khi click đúng chỗ. Đây là bức tranh thật.
Mô hình quyết định giỏi nhất với những câu hỏi hẹp, được xác định rõ. Trong một benchmark phát hiện phishing đã được công bố, hỏi Jev một câu chung chung ("email này có phải phishing không?") chỉ đạt độ chính xác 62.6%, so với 81.3% của Haiku. Nhưng khi chia cùng tác vụ đó thành năm câu hỏi hẹp, mô hình quyết định đạt 95.0%, vượt 93.2% của Haiku.
Lại là bài học về Hệ thống 1. Tư duy nhanh cực giỏi với những phán đoán đơn giản, cụ thể, nhưng kém với những câu hỏi phức tạp, mơ hồ. Vì vậy, thiết kế đúng là chia việc:
- Để LLM chia nhỏ tác vụ thành những quyết định nhỏ, cụ thể.
- Để mô hình quyết định trả lời từng quyết định nhỏ, như "phần tử nào?" hay "đã thành công chưa?"
- Dùng độ tin cậy làm lưới an toàn. Câu trả lời có độ tin cậy thấp được chuyển lại cho LLM thay vì đoán mò.
Trang web là đầu vào không đáng tin. Các nhà nghiên cứu bảo mật tại Check Point đã chỉ ra rằng mô hình quyết định cũng có thể bị tấn công bằng prompt injection y như LLM. Không gian đáp án cố định giúp hạn chế thiệt hại (mô hình chỉ có thể chọn trong các phương án mà code của bạn đưa ra), nhưng không loại bỏ hoàn toàn rủi ro. Đó là thêm một lý do SurfMind luôn để con người tham gia vào quy trình: browser actions luôn xin phép bạn trước khi chạy.
Mô hình quyết định trong SurfMind: tư duy nhanh và chậm ngay trong trình duyệt của bạn
Tính năng browser actions của SurfMind cho phép AI click, gõ phím và cuộn trang thay bạn, ngay trong những trang bạn đang dùng. Cho đến nay, mọi bước trong số đó đều chạy qua một mô hình ngôn ngữ.
Chúng tôi đang bổ sung một mô hình quyết định làm Hệ thống 1 cho SurfMind, bắt đầu với Jev:
- LLM bạn chọn là Hệ thống 2. Nó hiểu yêu cầu của bạn, lập kế hoạch cho tác vụ, viết bất kỳ văn bản nào cần viết và vào cuộc mỗi khi có gì đó chưa rõ ràng.
- Mô hình quyết định là Hệ thống 1. Nó lo những quyết định thường lệ, lặp đi lặp lại: tìm đúng phần tử, xác nhận một bước đã thành công, phát hiện pop-up và banner.
- Độ tin cậy quyết định việc chuyển giao. Quyết định chắc chắn thì cứ thế thực hiện. Quyết định chưa chắc thì chuyển cho mô hình đầy đủ, nhờ vậy bạn tiết kiệm tiền mà không phải đánh đổi độ tin cậy.
- Bạn luôn nắm quyền kiểm soát. Browser actions vẫn xin phép bạn trước khi chạy.
Mục tiêu rất đơn giản: vẫn là tự động hóa trình duyệt bạn đang dùng hôm nay, nhưng với chi phí chỉ bằng một phần nhỏ, và có thể rẻ hơn tới 50 lần so với chạy mọi bước chỉ bằng Claude Haiku. Điều này đúng với cách SurfMind luôn vận hành: dùng bao nhiêu trả bấy nhiêu, và chọn mô hình phù hợp với từng tác vụ thay vì trả giá cao cấp cho mọi thứ.
Muốn có AI làm việc ngay trong trình duyệt mà không phải lo hóa đơn khủng?
SurfMind mang hơn 300 mô hình AI cùng browser actions đến mọi trang bạn truy cập, và với mô hình quyết định, những cú click thường ngày sẽ rẻ hơn đáng kể.
Bài viết liên quan
Xem tất cả
BYOK là gì? Ý nghĩa của Bring Your Own Key và tương lai của công cụ AI
BYOK nghĩa là Bring Your Own Key: kết nối API key của bạn với công cụ AI thay vì trả phí đăng ký. Tìm hiểu cách tiết kiệm 40–90% và bắt đầu trong 5 phút.
Những mô hình OpenRouter miễn phí tốt nhất năm 2026 (và cách dùng thật sự)
OpenRouter có các mô hình miễn phí từ NVIDIA, Google, OpenAI và nhiều hãng khác. Đây là lựa chọn đáng dùng, giới hạn thực tế và cách chat ngay trên trình duyệt.
5 Cách Để Có AI Chất Lượng Claude/GPT Dưới 5 USD/Tháng
Bỏ qua các gói đăng ký 20 USD/tháng. Tìm hiểu cách truy cập các mô hình AI hàng đầu như Claude Sonnet 4.6, GPT-5.4 và Gemini 3 Flash với chi phí chỉ một phần nhỏ bằng cách sử dụng BYOK và chọn mô hình thông minh.