
 添加到 Chrome
什么是 AI 决策模型?Jev 如何让浏览器自动化成本降低 50 倍
AI 浏览器智能体在点击任何东西之前,得先搞清楚该点哪里。于是它把整个页面发给语言模型,问一句:“下一步该做什么?”模型读完整个页面,琢磨一番,再写出一段回答。然后智能体才去点击。
这一来一回的每个 token 都要算钱。单次点击,也就不到一美分。可如果是一个每天都要跑的 20 步任务,这笔账很快就滚起来了。
更有意思的是:这些问题大多其实很简单。“这几个按钮里哪个是‘加入购物车’?”“表单提交成功了吗?”“这是不是 Cookie 弹窗?”换成你,一眼就能答出来,根本不用动脑子。可大多数 AI 智能体偏偏用又慢又贵的方式来回答:每一次都让一个完整的语言模型写出一段回复。
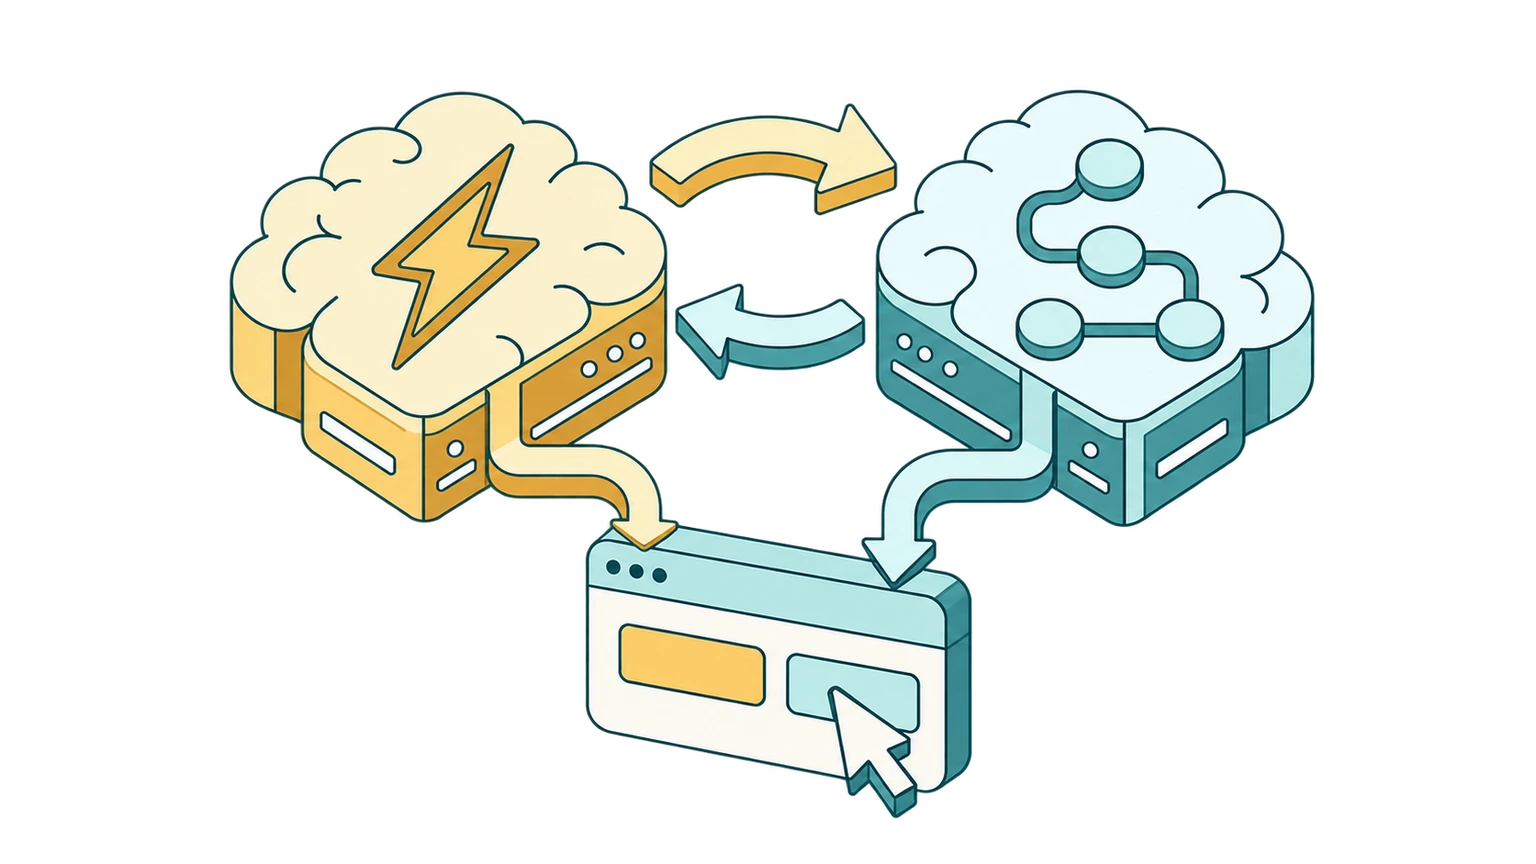
干这种活,其实有更趁手的工具:AI 决策模型。这个思路早就有了,但真正引起广泛关注是在 2026 年 9 月,TypeSafe AI 发布了 Jev——一个速度快、运行成本几乎可以忽略、几乎什么问题都能接的决策模型。本文会聊聊决策模型到底是什么,为什么丹尼尔·卡尼曼的《思考,快与慢》是理解它的最佳角度,以及把工作拆分给“快”模型和“慢”模型,如何让浏览器自动化比每一步都交给 Claude Haiku 这类小型 LLM 便宜多达 50 倍。而这正是我们要带到 SurfMind 浏览器操作里的能力。
什么是 AI 决策模型?
AI 决策模型只负责做决策。就这么简单。它不写东西。
你给它一个场景(比如一个网页),再加一个带固定选项的问题:“这 14 个元素里哪个是结账按钮?”或者“这个页面是不是被登录墙挡住了?”它会从你给的选项里挑一个,并告诉你它有多大把握。没有长篇大论,没有解释说明,事后也不用收拾烂摊子。
正因如此,它在软件里出奇地好用,原因有两个:
- 答案永远符合格式。 它只能从你给的选项里挑,所以你的代码拿到结果就能直接用。
- 它知道自己有几成把握。 好的决策模型是经过校准的:它说 90%,那它大约就有 90% 的时候是对的。这个置信度能告诉智能体,什么时候该直接执行,什么时候该求助。
Jev 就是个很好的例子。它从不写一个字,响应时间远低于一秒,成本只有 LLM 的零头。后面我们会用它公开的价格来算一算到底能省多少。
决策模型并不新鲜
“单独用一个只做判断的模型”这个想法已经存在好些年了,形式也有好几种:
- 微调分类器,比如基于 BERT 的模型(2018 年起),又快又准,但每个模型只会干一件事。垃圾邮件过滤器只会识别垃圾邮件,仅此而已。
- 零样本分类器,比如自然语言推理(NLI)模型,以及 GLiClass 这类较新的开源模型,可以在提问时临时定义标签,无需训练。
- 奖励模型和安全分类器,比如 Meta 的 Llama Guard,搭配在其他 AI 模型旁边,评判它们的输出。
- 当作分类器用的小型 LLM,不生成回复,而是直接读取每个选项的概率。OpenJev 等开源项目就是这么做的。
那 Jev 凭什么火了?它把这些思路整合进一个托管模型里:用大白话描述的问题它基本都能接,给出经过校准的置信度,定价也是为每天上百万次的决策量身设计的。独立对比评测发现,如果自己部署,开源替代方案在成本和隐私上已经占优,但遇到没见过的问题时,准确率仍然落后于 Jev。这也是本文通篇以 Jev 为例的原因。
决策模型 vs. LLM
Claude、GPT、Gemini 这类大语言模型(LLM)是一个 token 一个 token 地生成答案的。哪怕你只想要一个词的回答,LLM 也会把所有内容读一遍,“写”出回复,还常常顺带解释一番。这些你全都要付费,然后还得祈祷它的回复符合你要求的格式。
| LLM | 决策模型 | |
|---|---|---|
| 输出 | 自由文本 | 从你定义的选项中选出一个答案 |
| 能写作或逐步推理吗? | 能 | 不能 |
| 答案总符合你的格式? | 通常会,但不保证 | 始终符合 |
| 会告诉你把握有多大? | 不太靠谱 | 会,给出经过校准的概率 |
| 成本 | 输入和输出 token 都要付费 | 通常只算输入,价格只是零头 |
| 速度 | 较长回答需要数秒 | 通常远低于一秒 |
| 擅长 | 规划、写作、开放式推理 | 快速、重复、定义明确的判断 |
两者谁也取代不了谁。真正有意思的是把它们组合起来会发生什么——这就轮到卡尼曼登场了。
思考,快与慢:AI 的系统1与系统2
心理学家丹尼尔·卡尼曼在 2011 年出版的《思考,快与慢》中,描述了人类思考的两种模式:
- 系统1快速、自动、毫不费力。认出朋友的脸、看懂停车标志、知道 2 + 2 = 4。你用不着刻意去做,它自然就发生了。
- 系统2缓慢、审慎、需要费力。规划一次旅行、比较两份房贷方案、算出 17 × 24。它需要专注和精力,所以你会省着用。
关键洞见在于:我们每天做的大部分事情都靠系统1。只有碰到新鲜、困难或意外的情况,我们才会请出系统2。要是走路时每迈一步都得认真思考,那你哪儿也去不了。
如今的 AI 智能体只有系统2
如今大多数 AI 智能体什么事都交给大语言模型。LLM 负责规划任务,然后同一个 LLM 还要决定每一次点击、滚动和按键。这就好比请了一位资深分析师来规划项目,结果连每一张复印件都让他亲手去印。
结果可想而知:智能体又慢又贵,偶尔还会在本该轻而易举的一步上,因为一条格式错误的回复而“翻车”。
决策模型给了 AI 一个系统1
决策模型正是缺失的那个系统1:一个快速、便宜、自动的判断层,负责处理日常的例行判断,并且知道什么时候该把问题交出去。
把两者结合起来,整个架构看起来就很像人类的大脑:
- 系统2(LLM) 理解你的需求、制定计划、撰写文本,并处理一切不寻常的情况。
- 系统1(决策模型) 负责执行计划过程中大量快速、重复的决策。
- 置信度就是交接信号。 决策模型有把握时,智能体直接执行;没把握时,问题就升级给 LLM——就像人觉得哪里不对劲时,会切换到认真思考模式一样。
为什么如今的浏览器自动化这么贵
想知道省钱省在哪儿,先看看 AI 浏览器智能体每一步实际在干什么:
- 读取页面。 智能体抓取页面状态:简化后的 DOM、无障碍树,或者一张截图。
- 做决策。 模型读取这些状态,加上目标和之前各步的历史记录,选出下一个操作。
- 执行。 智能体点击、输入或滚动。
- 检查。 模型查看新页面,确认操作是否成功。
然后循环往复。最贵的是第 2 步。页面状态体量很大,每一步往往就是几千个 token,而且很多智能体每一步还会把不断变长的任务历史重新发一遍。据行业文章统计,一个典型的多步骤浏览器任务要消耗 20,000 到 60,000 个 token,而且 LLM 写出每个操作时还要按输出价格计费。
问题的关键在于:一旦页面被整理成一份候选元素列表,其中大多数步骤就不再是语言问题了,而是选择题。“这些元素里我该点哪个?”“页面有没有按预期发生变化?”这就是系统1的活儿,也正是决策模型的看家本领。
决策模型如何把浏览器操作成本最多降低 50 倍
为了用真实数字说话,我们拿 Jev 和 Claude Haiku 4.5 做个对比——后者是主流 AI 实验室中最实惠的 LLM 之一。TypeSafe 把 Jev 称作“System One model”(系统1模型),直接借用了卡尼曼的术语。
- Jev 的价格是每百万输入 token $0.042,输出免费(见 OpenRouter)。响应时间通常在 70 到 500 毫秒之间。
- Claude Haiku 4.5 的价格是每百万输入 token $1.00,每百万输出 token $5.00。
以浏览器任务中一个普通的例行步骤为例,比如选出该点击的正确元素。
用 LLM(Claude Haiku 4.5)完成这一步:智能体发送约 12,000 个输入 token(指令、工具定义、页面状态和任务历史),并收到约 200 个描述操作的输出 token。
- 输入:12,000 × $1.00 / 1M = $0.0120
- 输出:200 × $5.00 / 1M = $0.0010
- 合计:每步约 $0.013
用决策模型(Jev)完成同一步:它不需要聊天历史,也不需要工具定义。它只接收这一步的目标和候选元素,大约 6,000 个输入 token,然后返回一个选择和置信度。输出免费。
- 输入:6,000 × $0.042 / 1M = $0.00025
- 输出:$0
- 合计:每步约 $0.00025
也就是说,每个例行步骤的成本大约降低了 50 倍,而且答案通常在一秒之内就能返回。
放到整个任务上意味着什么
真实的任务总归需要系统2出场:LLM 得理解你的需求并制定计划,有些步骤也确实存在歧义。所以整个任务能省多少,最关键的只有一点:决策模型把步骤交回给 LLM 的频率有多高。
下面是一个 20 步的任务,采用上面的每步成本计算,混合方案中包含一次 Haiku 规划调用(约 $0.0075):
| 方案 | 每个任务成本 | 1,000 个任务成本 | 相比纯 LLM 的节省 |
|---|---|---|---|
| 每一步都用 LLM(Haiku) | $0.260 | $260 | 基准 |
| LLM 规划、决策模型决策,10% 的步骤升级 | $0.039 | $39 | 约便宜 7 倍 |
| LLM 规划、决策模型决策,0% 升级 | $0.013 | $13 | 约便宜 20 倍 |
| 仅用决策模型,用于重复或预先规划好的工作流 | $0.005 | $5 | 约便宜 50 倍 |
以上为基于公开标价的示意性估算。实际数字取决于页面大小、任务步骤数、提示缓存,以及任务需要调用 LLM 的频率。
规律很明显:你的自动化里例行操作越多,就越接近 50 倍那一端。那些反复运行的工作流——填同一张表单、查看同一个仪表盘、分拣同一类页面——正是决策模型大显身手的地方。
独立测试也印证了这一点。在一项 LiteLLM 路由测试中,240 次 Jev 调用花费 $0.0077,而同样的调用在 Claude Haiku 4.5 上花费 $0.1985,便宜了约 26 倍。
速度也更快
省钱还不是唯一的好处。一项独立基准测试显示,Jev 的中位响应时间为 239 毫秒,而 Claude Haiku 4.5 为 687 毫秒,大约快 3 倍。一个 20 步的任务下来,你能少等浏览器好几秒。同一测试还记录到,决策模型的格式错误输出为零——毕竟它只能从给定的选项里选一个作答。
决策模型够准吗?
便宜的前提是点得对。下面说说实情。
决策模型最擅长范围窄、定义清晰的问题。在一项公开的钓鱼邮件检测基准测试中,只问 Jev 一个宽泛的问题(“这封邮件是钓鱼邮件吗?”),准确率为 62.6%,而 Haiku 为 81.3%。但把同一个任务拆成五个具体的小问题后,决策模型的准确率达到了 95.0%,超过了 Haiku 的 93.2%。
这又回到了系统1的道理。快思考擅长简单、具体的判断,却不擅长复杂、模糊的问题。所以正确的设计是分工协作:
- 让 LLM 拆解任务,把它分成一个个小而具体的决策。
- 让决策模型回答每个小决策,比如“选哪个元素?”或“成功了吗?”
- 把置信度当作安全网。 低置信度的答案交回给 LLM,而不是瞎猜。
网页是不可信的输入。 Check Point 的安全研究人员已经证明,决策模型和 LLM 一样可能遭受提示注入攻击。固定的答案空间能限制危害(模型只能从你的代码给出的选项中挑选),但并不能消除风险。这也是 SurfMind 坚持让人参与把关的又一个原因:浏览器操作在执行前都会征得你的许可。
SurfMind 中的决策模型:在浏览器里实现快思考与慢思考
SurfMind 的浏览器操作可以让 AI 代你点击、输入和滚动,直接在你正在使用的页面里完成。到目前为止,这其中的每一步都要经过语言模型。
我们正在为 SurfMind 加入决策模型作为系统1,首先接入的就是 Jev:
- 你选择的 LLM 是系统2。 它理解你的需求、规划任务、撰写文本,并在情况不明时随时介入。
- 决策模型是系统1。 它负责例行、重复的决策:找到正确的元素、确认某一步是否成功、识别弹窗和横幅。
- 置信度决定交接。 有把握的决策直接执行,没把握的交给完整模型——省钱的同时不牺牲可靠性。
- 一切尽在你的掌控。 浏览器操作在执行前依然会征得你的许可。
目标很简单:还是你现在用的浏览器自动化,成本却只是零头,有望比每一步都用 Claude Haiku 便宜多达 50 倍。这也契合 SurfMind 一贯的理念:用多少付多少,按任务选模型,而不是不管什么都付高价。
想让 AI 在浏览器里帮你干活,又不想收到天价账单?
SurfMind 为你访问的每个页面带来 300 多个 AI 模型和浏览器操作。有了决策模型,那些例行点击的成本将大幅降低。
相关文章
查看全部
BYOK 是什么意思?自带 API Key 为何是 AI 工具的未来
BYOK 即自带 API Key:把自己的 API 密钥接入 AI 工具,无需支付订阅费。了解它如何节省 40–90% 的费用,并在 5 分钟内开始使用。
2026 年最佳免费 OpenRouter 模型(以及真正的使用方法)
OpenRouter 汇集 NVIDIA、Google、OpenAI 等公司的免费模型。本文介绍值得使用的模型、实际限额,以及如何在浏览器中使用它们。
5 种方法,每月不到 5 美元用上 Claude/GPT 级 AI
跳过每月20美元的订阅费用。了解如何通过自带密钥(BYOK)和智能模型选择,以极低成本访问顶级AI模型,如Claude Sonnet 4.6、GPT-5.4和Gemini 3 Flash。