
 أضِفه إلى Chrome
ما هو نموذج القرار في الذكاء الاصطناعي؟ وكيف يجعل Jev أتمتة المتصفح أرخص بـ50 مرة
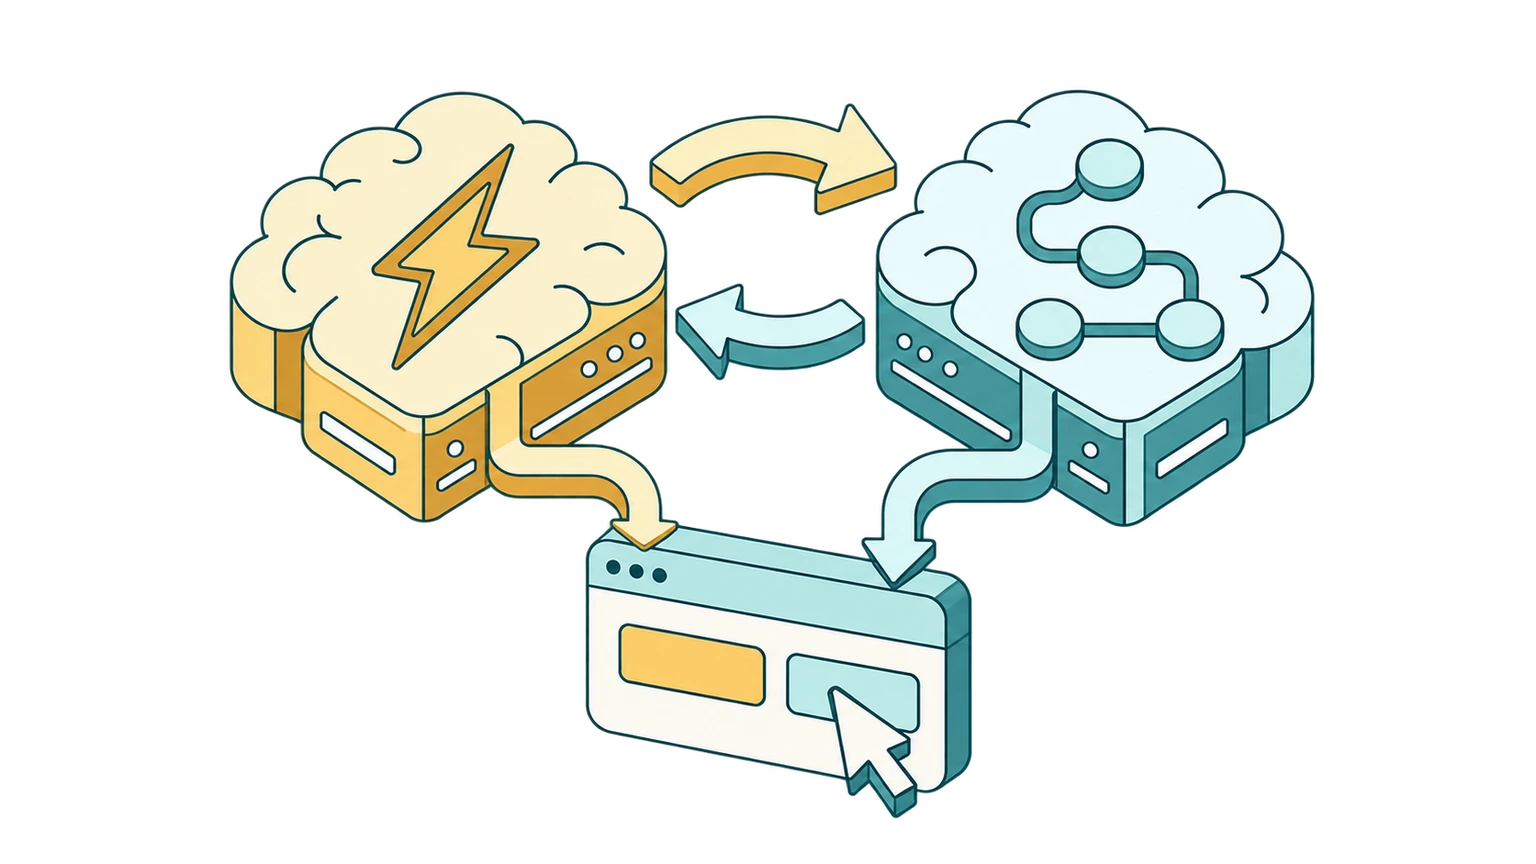
قبل أن ينقر وكيل المتصفح الذكي على أي شيء، عليه أن يعرف أين ينقر. فيرسل الصفحة إلى نموذج لغوي ويسأله: "ما الخطوة التالية؟" يقرأ النموذج الصفحة كاملة، ويفكّر قليلًا، ثم يكتب الإجابة. وبعدها فقط ينقر الوكيل.
وأنت تدفع ثمن كل رمز (token) في هذه الرحلة ذهابًا وإيابًا. في نقرة واحدة، المبلغ مجرد جزء من السنت. لكن في مهمة من 20 خطوة تشغّلها كل يوم؟ الفاتورة تكبر بسرعة.
والمضحك في الأمر أن معظم هذه الأسئلة سهلة. "أيّ هذه الأزرار هو زر 'أضف إلى السلة'؟" "هل أُرسل النموذج؟" "هل هذا شريط ملفات تعريف الارتباط؟" أنت تجيب عنها في لمح البصر دون أن تفكّر فعلًا. ومع ذلك يجيب عنها معظم وكلاء الذكاء الاصطناعي بالطريقة البطيئة والمكلفة: يطلبون من نموذج لغوي كامل أن يكتب ردًا في كل مرة، بلا استثناء.
وهناك أداة أنسب لهذه المهمة: نموذج القرار في الذكاء الاصطناعي. الفكرة ليست جديدة، لكنها لفتت الأنظار بقوة في سبتمبر 2026 حين أطلقت TypeSafe AI نموذج Jev، وهو نموذج قرار سريع، وتكلفة تشغيله شبه معدومة، ويتعامل مع أي سؤال تقريبًا تطرحه عليه. في هذا المقال سنتعرف على نماذج القرار، ولماذا يُعد كتاب دانيال كانمان «التفكير السريع والبطيء» أفضل مدخل لفهمها، وكيف يمكن لتقسيم العمل بين نماذج "سريعة" وأخرى "بطيئة" أن يجعل أتمتة المتصفح أرخص بما يصل إلى 50 مرة مقارنةً بتمرير كل خطوة عبر LLM صغير مثل Claude Haiku. وهذا بالضبط ما نضيفه إلى إجراءات المتصفح في SurfMind.
ما هو نموذج القرار في الذكاء الاصطناعي؟
نموذج القرار في الذكاء الاصطناعي يتخذ قرارات. هذا كل شيء. لا يكتب.
تعطيه موقفًا (صفحة ويب مثلًا) وسؤالًا له مجموعة ثابتة من الإجابات المحتملة: "أيّ هذه العناصر الـ14 هو زر الدفع؟" أو "هل هناك جدار تسجيل دخول يحجب هذه الصفحة؟" فيختار إحدى إجاباتك ويخبرك بمدى ثقته. لا فقرات، ولا شروحات، ولا شيء تحتاج إلى تنظيفه بعد ذلك.
وهذا ما يجعله مفيدًا على نحو مدهش داخل البرمجيات، لسببين:
- الإجابة مناسبة دائمًا. لا يمكنه الاختيار إلا من الخيارات التي أعطيته إياها، فيستطيع الكود التصرف بناءً على النتيجة فورًا.
- يعرف مدى ثقته. نموذج القرار الجيد يكون معايَرًا (calibrated): حين يقول 90%، يكون محقًا في نحو 90% من الحالات. وهذه الثقة تخبر الوكيل متى يمضي قدمًا ومتى يطلب المساعدة.
ويُعد Jev مثالًا جيدًا. فهو لا يكتب كلمة واحدة، ويجيب في أقل من ثانية بكثير، وتكلفته جزء صغير مما يكلّفه LLM. وسنستخدم أسعاره المنشورة لاحقًا لحساب حجم التوفير.
نماذج القرار ليست جديدة
فكرة وجود نموذج منفصل لا يفعل شيئًا سوى إصدار الأحكام موجودة منذ سنوات، وبأشكال مختلفة:
- المصنِّفات المضبوطة بدقة (Fine-tuned) مثل النماذج المبنية على BERT (منذ 2018) سريعة ودقيقة، لكن كلًّا منها لا يعرف إلا مهمة واحدة. مرشّح الرسائل المزعجة يكشف الرسائل المزعجة، ولا شيء غير ذلك.
- المصنِّفات بلا أمثلة مسبقة (Zero-shot)، مثل نماذج الاستدلال اللغوي الطبيعي (NLI) والنماذج المفتوحة الأحدث مثل GLiClass، تتيح لك اختيار التصنيفات لحظة السؤال، دون أي تدريب.
- نماذج المكافأة ومصنِّفات الأمان، مثل Llama Guard من Meta، تعمل بجانب نماذج ذكاء اصطناعي أخرى وتحكم على ما تنتجه.
- نماذج LLM صغيرة تُستخدم كمصنِّفات تتجاوز كتابة الرد، وتكتفي بقراءة احتمال كل خيار من خيارات الإجابة. وتعمل مشاريع مفتوحة مثل OpenJev بهذه الطريقة.
إذن لماذا انتشر Jev؟ لأنه يجمع هذه الأفكار في نموذج مستضاف واحد يتعامل مع أي سؤال تقريبًا تصفه بلغة بسيطة، ويمنحك ثقة معايَرة، وسعره مصمَّم لقرارات تتكرر ملايين المرات يوميًا. وتُظهر مقارنات مستقلة أن البدائل المفتوحة تتفوق بالفعل في التكلفة والخصوصية إذا شغّلتها بنفسك، لكنها ما زالت متأخرة عن Jev في الدقة حين يكون السؤال جديدًا عليها. ولهذا سنعتمد Jev مثالًا طوال هذا المقال.
نماذج القرار مقابل نماذج LLM
النموذج اللغوي الكبير (LLM) مثل Claude أو GPT أو Gemini يولّد إجابته رمزًا تلو الآخر. وحتى حين لا تريد سوى إجابة من كلمة واحدة، يقرأ الـLLM كل شيء، و"يكتب" رده، وكثيرًا ما يشرح نفسه أيضًا. وأنت تدفع ثمن ذلك كله، ثم تأمل أن يأتي الرد بالتنسيق الذي طلبته.
| LLM | نموذج القرار | |
|---|---|---|
| المخرجات | نص حر | إجابة واحدة من الخيارات التي تحددها |
| هل يستطيع الكتابة أو الاستدلال خطوة بخطوة؟ | نعم | لا |
| هل الإجابة بتنسيقك دائمًا؟ | غالبًا، لا دائمًا | دائمًا |
| هل يخبرك بمدى ثقته؟ | ليس بشكل موثوق | نعم، باحتمال معايَر |
| التكلفة | تدفع مقابل رموز الإدخال والإخراج | عادةً الإدخال فقط، وبجزء بسيط من السعر |
| السرعة | ثوانٍ للإجابات الأطول | عادةً أقل من ثانية بكثير |
| يتفوق في | التخطيط والكتابة والاستدلال المفتوح | الأحكام السريعة والمتكررة والمحددة بوضوح |
لا يُغني أحدهما عن الآخر. الجزء المثير هو ما يحدث حين تجمع بينهما، وهنا يأتي دور كانمان.
التفكير السريع والبطيء: النظام 1 والنظام 2 في الذكاء الاصطناعي
في كتابه الصادر عام 2011 «التفكير السريع والبطيء»، يصف عالم النفس دانيال كانمان نمطين من التفكير البشري:
- النظام 1 سريع وتلقائي ولا يتطلب جهدًا. التعرّف على وجه صديق، وقراءة إشارة توقف، ومعرفة أن 2 + 2 = 4. أنت لا تقرر فعل ذلك؛ إنه يحدث وحسب.
- النظام 2 بطيء ومتأنٍّ ويتطلب جهدًا. التخطيط لرحلة، والمقارنة بين عرضَي تمويل عقاري، وحساب 17 × 24. يستهلك الانتباه والطاقة، لذا تستخدمه باقتصاد.
والفكرة الجوهرية هنا أن معظم ما نفعله طوال اليوم هو من عمل النظام 1. ولا نستدعي النظام 2 إلا حين يكون الأمر جديدًا أو صعبًا أو مفاجئًا. لو اضطررت إلى التفكير بوعي في كل خطوة تخطوها أثناء المشي، لما وصلت إلى أي مكان.
وكلاء الذكاء الاصطناعي اليوم لا يملكون إلا النظام 2
معظم وكلاء الذكاء الاصطناعي اليوم يستخدمون نموذجًا لغويًا كبيرًا لكل شيء. يخطط الـLLM للمهمة، ثم يقرر الـLLM نفسه كل نقرة وكل تمرير وكل ضغطة مفتاح. الأمر أشبه بتعيين محلل أول لتخطيط مشروع، ثم مطالبته بأن يصوّر كل المستندات بنفسه أيضًا.
والنتيجة متوقعة: وكلاء بطيئون ومكلفون، ويخرجون عن المسار أحيانًا بسبب رد مشوّه في خطوة كان يُفترض أن تكون بديهية.
نماذج القرار تمنح الذكاء الاصطناعي نظامًا 1
نموذج القرار هو النظام 1 المفقود: طبقة أحكام سريعة ورخيصة وتلقائية تتولى القرارات الروتينية، وتعرف متى تسلّم الدفة لغيرها.
اجمع الاثنين معًا، وستجد أن البنية تشبه العقل البشري إلى حد كبير:
- النظام 2 (الـLLM) يفهم ما طلبته، ويضع الخطة، ويكتب أي نص، ويتعامل مع كل ما هو غير مألوف.
- النظام 1 (نموذج القرار) يتخذ القرارات الكثيرة السريعة والمتكررة اللازمة لتنفيذ الخطة.
- الثقة هي إشارة التسليم. حين يكون نموذج القرار واثقًا، يتصرف الوكيل. وحين لا يكون كذلك، يُحال السؤال إلى الـLLM، تمامًا كما ينتقل الإنسان إلى التفكير المتأني حين يشعر أن شيئًا ما ليس على ما يرام.
لماذا أتمتة المتصفح مكلفة اليوم
لتعرف من أين يأتي التوفير، انظر إلى ما يفعله وكيل المتصفح الذكي فعليًا في كل خطوة:
- قراءة الصفحة. يلتقط الوكيل حالة الصفحة: نسخة مبسطة من DOM، أو شجرة إمكانية الوصول، أو لقطة شاشة.
- اتخاذ القرار. يقرأ النموذج تلك الحالة، إضافةً إلى الهدف وسجل الخطوات السابقة، ويختار الإجراء التالي.
- التنفيذ. ينقر الوكيل أو يكتب أو يمرّر الصفحة.
- التحقق. ينظر النموذج إلى الصفحة الجديدة ليرى هل نجح الأمر.
ثم يعيد الكرّة. الجزء المكلف هو الخطوة 2. فحالة الصفحة كبيرة، وغالبًا ما تبلغ آلاف الرموز في كل خطوة، وكثير من الوكلاء يعيدون أيضًا إرسال سجل المهمة المتنامي في كل خطوة. وتقدّر تقارير القطاع مهمة المتصفح النموذجية متعددة الخطوات بما بين 20,000 و60,000 رمز، فضلًا عن أن الـLLM يدفع أسعار المخرجات لكتابة كل إجراء.
وإليك بيت القصيد: بمجرد تحويل الصفحة إلى قائمة من العناصر المرشحة، تصبح معظم تلك الخطوات ليست مسائل لغوية أصلًا. إنها أسئلة اختيار من متعدد. "أيّ هذه العناصر يجب أن أنقر عليه؟" "هل تغيرت الصفحة كما توقعنا؟" هذا عمل النظام 1، وهو بالضبط ما صُمّمت نماذج القرار من أجله.
كيف تخفض نماذج القرار تكلفة إجراءات المتصفح حتى 50 مرة
لنضع أرقامًا حقيقية على التوفير، سنقارن Jev مع Claude Haiku 4.5، أحد أرخص نماذج LLM من مختبرات الذكاء الاصطناعي الكبرى. وتسمّي TypeSafe نموذج Jev بـ"System One model" (أي "نموذج النظام 1")، مستعيرةً مصطلح كانمان مباشرةً.
- Jev يكلّف $0.042 لكل مليون رمز إدخال، والمخرجات مجانية (على OpenRouter). وتصل الإجابات عادةً خلال 70 إلى 500 مللي ثانية.
- Claude Haiku 4.5 يكلّف $1.00 لكل مليون رمز إدخال و$5.00 لكل مليون رمز إخراج.
خذ خطوة روتينية واحدة في مهمة على المتصفح، مثل اختيار العنصر الصحيح للنقر عليه.
باستخدام LLM (Claude Haiku 4.5) لهذه الخطوة: يرسل الوكيل نحو 12,000 رمز إدخال (التعليمات، وتعريفات الأدوات، وحالة الصفحة، وسجل المهمة)، ويتلقى نحو 200 رمز إخراج تصف الإجراء.
- الإدخال: 12,000 × $1.00 / 1M = $0.0120
- الإخراج: 200 × $5.00 / 1M = $0.0010
- الإجمالي: نحو $0.013 للخطوة
باستخدام نموذج قرار (Jev) للخطوة نفسها: لا يحتاج إلى سجل المحادثة ولا إلى تعريفات الأدوات. يتلقى هدف هذه الخطوة والعناصر المرشحة، أي نحو 6,000 رمز إدخال، ويعيد اختيارًا مع درجة الثقة. والمخرجات مجانية.
- الإدخال: 6,000 × $0.042 / 1M = $0.00025
- الإخراج: $0
- الإجمالي: نحو $0.00025 للخطوة
أي تكلفة أقل بنحو 50 مرة لكل خطوة روتينية، والإجابة تصل عادةً في أقل من ثانية بكثير.
ماذا يعني ذلك لمهمة كاملة
المهمة الحقيقية ما زالت تحتاج إلى النظام 2 في مكان ما: على الـLLM أن يفهم طلبك ويخطط له، وبعض الخطوات ستكون ملتبسة فعلًا. لذا يعتمد التوفير في المهمة الكاملة على عامل واحد قبل أي شيء آخر: كم مرة يعيد نموذج القرار الخطوة إلى الـLLM.
إليك مهمة من 20 خطوة، باستخدام أرقام الخطوة الواحدة أعلاه، مع استدعاء تخطيط واحد لـHaiku (~$0.0075) في الإعداد الهجين:
| الإعداد | التكلفة لكل مهمة | التكلفة لكل 1,000 مهمة | التوفير مقارنةً بـLLM فقط |
|---|---|---|---|
| LLM (Haiku) لكل خطوة | $0.260 | $260 | خط الأساس |
| الـLLM يخطط، ونموذج القرار يقرر، مع إحالة 10% من الخطوات | $0.039 | $39 | أرخص بنحو 7 مرات |
| الـLLM يخطط، ونموذج القرار يقرر، دون أي إحالة | $0.013 | $13 | أرخص بنحو 20 مرة |
| نموذج القرار وحده، في سير عمل متكرر أو مخطط مسبقًا | $0.005 | $5 | أرخص بنحو 50 مرة |
تقديرات توضيحية مبنية على الأسعار المعلنة للعموم. تعتمد الأرقام الفعلية على حجم الصفحة، وعدد خطوات المهمة، والتخزين المؤقت للموجّهات (prompt caching)، وعدد المرات التي تحتاج فيها المهمة إلى الـLLM.
والنمط واضح: كلما كانت أتمتتك روتينية أكثر، اقتربت من طرف الـ50 مرة. سير العمل المتكرر الذي تشغّله مرة بعد مرة، مثل ملء النموذج نفسه، أو مراجعة لوحة التحكم نفسها، أو فرز النوع نفسه من الصفحات، هو المكان الذي تتألق فيه نماذج القرار.
والاختبارات المستقلة تشير إلى الاتجاه نفسه. ففي أحد اختبارات التوجيه عبر LiteLLM، كلّفت 240 استدعاءً لـJev مبلغ $0.0077 مقابل $0.1985 للاستدعاءات نفسها على Claude Haiku 4.5، أي أرخص بنحو 26 مرة.
وأسرع أيضًا
التكلفة ليست المكسب الوحيد. فقد قاس اختبار أداء مستقل متوسط زمن استجابة Jev (الوسيط) بـ239 مللي ثانية مقابل 687 مللي ثانية لـClaude Haiku 4.5، أي أسرع بنحو 3 مرات. وعلى امتداد مهمة من 20 خطوة، هذه ثوانٍ كثيرة لن تقضيها في انتظار متصفحك. كما سجّل الاختبار نفسه صفر مخرجات مشوّهة من نموذج القرار، لأنه لا يستطيع الإجابة إلا بأحد الخيارات المعطاة له.
هل نماذج القرار دقيقة بما يكفي؟
الرخص لا قيمة له إن لم تكن النقرات صحيحة. وإليك الصورة بصراحة.
نماذج القرار تتفوق في الأسئلة الضيقة والمحددة بوضوح. في اختبار أداء منشور لكشف التصيد الاحتيالي، حين سُئل Jev سؤالًا واحدًا عامًا ("هل هذا البريد الإلكتروني تصيّد احتيالي؟")، حقق دقة 62.6% مقابل 81.3% لـHaiku. لكن حين قُسّمت المهمة نفسها إلى خمسة أسئلة ضيقة، بلغ نموذج القرار 95.0%، متقدمًا على Haiku الذي حقق 93.2%.
إنه درس النظام 1 من جديد. التفكير السريع ممتاز في الأحكام البسيطة والمحددة، وضعيف في الأحكام المعقدة والغامضة. لذا فالتصميم الصحيح يقسّم العمل:
- دع الـLLM يفكّك المهمة إلى قرارات صغيرة وملموسة.
- دع نموذج القرار يجيب عن كل قرار صغير، مثل "أيّ عنصر؟" أو "هل نجح الأمر؟"
- استخدم الثقة كشبكة أمان. الإجابات منخفضة الثقة تعود إلى الـLLM بدلًا من التخمين.
صفحات الويب مُدخلات غير موثوقة. أثبت باحثو الأمن في Check Point أن نماذج القرار يمكن استهدافها بحقن الموجّهات (prompt injection) تمامًا كنماذج LLM. ومساحة الإجابات الثابتة تحدّ من الضرر (فالنموذج لا يستطيع الاختيار إلا من الخيارات التي أعطاه إياها الكود)، لكنها لا تلغي الخطر. وهذا سبب إضافي لحرص SurfMind على إبقاء الإنسان جزءًا من العملية: إجراءات المتصفح تطلب إذنك قبل تنفيذها.
نماذج القرار في SurfMind: تفكير سريع وبطيء داخل متصفحك
تتيح إجراءات المتصفح في SurfMind للذكاء الاصطناعي أن ينقر ويكتب ويمرّر نيابةً عنك، مباشرةً داخل الصفحات التي تستخدمها أصلًا. وحتى الآن، كانت كل خطوة من هذه الخطوات تمرّ عبر نموذج لغوي.
ونحن الآن نضيف نموذج قرار ليكون النظام 1 في SurfMind، بدءًا بـJev:
- الـLLM الذي تختاره هو النظام 2. يفهم طلبك، ويخطط للمهمة، ويكتب أي نص، ويتدخل كلما كان هناك شيء غير واضح.
- نموذج القرار هو النظام 1. يتولى القرارات الروتينية المتكررة: العثور على العنصر الصحيح، والتأكد من نجاح الخطوة، ورصد النوافذ المنبثقة والأشرطة.
- الثقة تحدد التسليم. القرارات الواثقة تُنفَّذ مباشرةً. أما غير المؤكدة فتذهب إلى النموذج الكامل، فتوفّر المال دون أن تتنازل عن الموثوقية.
- التحكم يبقى بيدك. ما زالت إجراءات المتصفح تطلب إذنك قبل تنفيذها.
الهدف بسيط: أتمتة المتصفح نفسها التي تستخدمها اليوم، بجزء بسيط من التكلفة، وربما أقل بما يصل إلى 50 مرة من تمرير كل خطوة عبر Claude Haiku وحده. وهذا ينسجم مع طريقة عمل SurfMind منذ البداية: ادفع فقط مقابل ما تستخدمه، واختر النموذج المناسب للمهمة بدلًا من دفع أسعار مرتفعة مقابل كل شيء.
تريد ذكاءً اصطناعيًا يعمل في متصفحك دون فاتورة ضخمة؟
يجلب SurfMind أكثر من 300 نموذج ذكاء اصطناعي وإجراءات المتصفح إلى كل صفحة تزورها، ومع نماذج القرار، تصبح النقرات الروتينية أرخص بكثير.
منشورات ذات صلة
عرض الكل
معنى BYOK: ما هو Bring Your Own Key ولماذا يمثل مستقبل أدوات الذكاء الاصطناعي
يعني BYOK استخدام مفتاح API الخاص بك مع أدوات الذكاء الاصطناعي بدلاً من دفع اشتراكات. تعرّف على طريقة توفير 40–90% والبدء خلال 5 دقائق.
أفضل نماذج OpenRouter المجانية في 2026 (وكيف تستخدمها فعلياً)
يستضيف OpenRouter نماذج مجانية من NVIDIA وGoogle وOpenAI وغيرها. تعرّف إلى النماذج التي تستحق التجربة وحدودها وطريقة استخدامها في المتصفح.
5 طرق للحصول على ذكاء اصطناعي بجودة Claude/GPT بأقل من 5 دولارات شهريًا
تخطى اشتراكات الـ20 دولارًا شهريًا. تعرّف على كيفية الوصول إلى نماذج الذكاء الاصطناعي ذات المستوى العالي مثل Claude Sonnet 4.6، وGPT-5.4، وGemini 3 Flash بجزء بسيط من التكلفة باستخدام BYOK واختيار النماذج الذكية.