
 Aggiungi a Chrome
Cos'è un modello decisionale IA? Come Jev rende l'automazione del browser 50 volte più economica
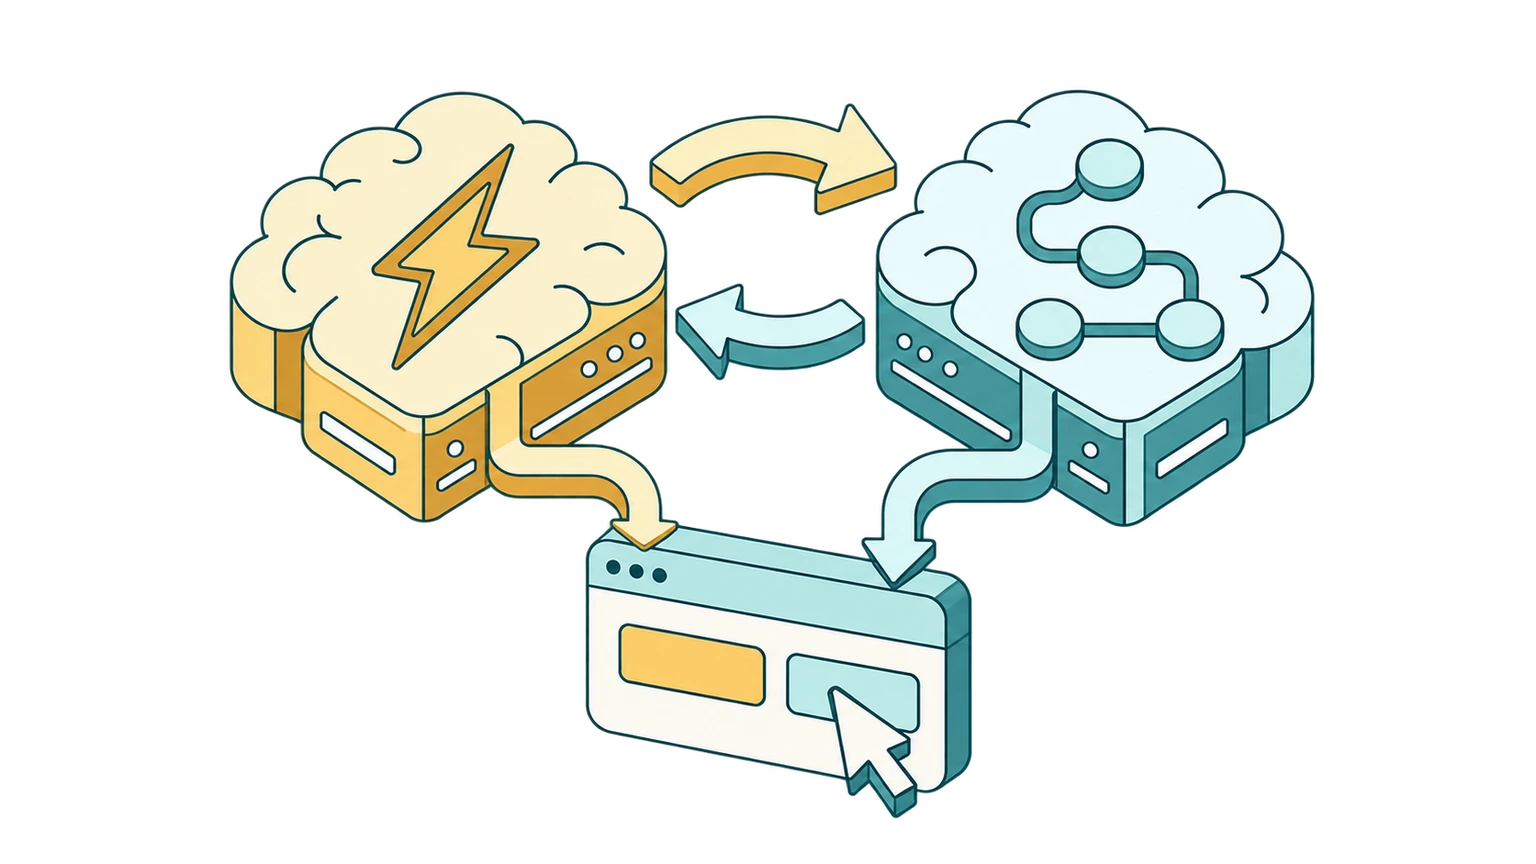
Prima di cliccare qualsiasi cosa, un agente IA nel browser deve capire cosa cliccare. Così manda la pagina a un modello linguistico e chiede: "Cosa faccio adesso?". Il modello legge tutta la pagina, ci ragiona su e scrive una risposta. Solo allora l'agente clicca.
Ogni token di questo andirivieni lo paghi tu. Per un singolo clic parliamo di una frazione di centesimo. Ma per un'attività da 20 passaggi che esegui ogni giorno, il conto sale in fretta.
E qui viene il bello: la maggior parte di queste domande è banale. "Quale di questi pulsanti è 'Aggiungi al carrello'?" "Il modulo è stato inviato?" "Questo è un banner dei cookie?" Tu risponderesti in un attimo, senza nemmeno pensarci. Eppure quasi tutti gli agenti IA ci rispondono nel modo lento e costoso, chiedendo ogni singola volta a un modello linguistico completo di scrivere una risposta.
Per questo lavoro esiste uno strumento migliore: il modello decisionale IA. L'idea circola da un po', ma a settembre 2026 ha attirato molta più attenzione quando TypeSafe AI ha lanciato Jev, un modello decisionale veloce, che costa quasi niente e funziona praticamente con qualsiasi domanda tu gli faccia. In questo articolo vediamo cosa sono i modelli decisionali, perché Pensieri lenti e veloci di Daniel Kahneman è il modo migliore per capirli e come dividere il lavoro tra modelli "veloci" e "lenti" può rendere l'automazione del browser fino a 50 volte più economica rispetto a far passare ogni passaggio da un piccolo LLM come Claude Haiku. Ed è proprio quello che stiamo portando nelle azioni del browser di SurfMind.
Cos'è un modello decisionale IA?
Un modello decisionale IA prende decisioni. Punto. Non scrive.
Gli dai una situazione (per esempio una pagina web) e una domanda con un insieme fisso di risposte possibili: "Quale di questi 14 elementi è il pulsante per il checkout?" oppure "C'è una schermata di login che blocca questa pagina?". Lui sceglie una delle tue risposte e ti dice quanto ne è sicuro. Niente paragrafi, niente spiegazioni, niente da ripulire dopo.
Questo lo rende sorprendentemente utile all'interno del software, per due motivi:
- La risposta è sempre nel formato giusto. Può scegliere solo tra le opzioni che gli hai dato, quindi il tuo codice può usare subito il risultato.
- Sa quanto è sicuro. Un buon modello decisionale è calibrato: quando dice 90%, ha ragione circa il 90% delle volte. Quella sicurezza dice all'agente quando andare avanti e quando chiedere aiuto.
Jev è un ottimo esempio. Non scrive mai una parola, risponde in molto meno di un secondo e costa una piccola frazione rispetto a un LLM. Più avanti useremo i suoi prezzi pubblici per calcolare il risparmio.
I modelli decisionali non sono una novità
L'idea di un modello separato che si limita a esprimere giudizi esiste da anni, in varie forme:
- Classificatori addestrati ad hoc (fine-tuned), come i modelli basati su BERT (dal 2018), sono veloci e precisi, ma ognuno sa fare una cosa sola. Un filtro antispam riconosce lo spam, e basta.
- Classificatori zero-shot, come i modelli di inferenza in linguaggio naturale (NLI) e modelli aperti più recenti come GLiClass, ti permettono di inventare le etichette al momento della domanda, senza alcun addestramento.
- Modelli di reward e classificatori di sicurezza, come Llama Guard di Meta, lavorano accanto ad altri modelli IA e giudicano quello che producono.
- Piccoli LLM usati come classificatori saltano la scrittura della risposta e si limitano a leggere quanto è probabile ciascuna opzione. Progetti aperti come OpenJev funzionano così.
E allora perché Jev ha sfondato? Mette insieme tutte queste idee in un unico modello in hosting che gestisce quasi qualsiasi domanda descritta in linguaggio naturale, ti restituisce una sicurezza calibrata e ha un prezzo pensato per decisioni che si ripetono milioni di volte al giorno. Alcuni confronti indipendenti rilevano che le alternative open vincono già su costi e privacy se le fai girare in casa, ma restano indietro rispetto a Jev in precisione quando la domanda è nuova per loro. Ecco perché in tutto l'articolo useremo Jev come esempio.
Modelli decisionali vs. LLM
Un modello linguistico di grandi dimensioni (LLM) come Claude, GPT o Gemini genera la risposta un token alla volta. Anche quando ti basta una parola, l'LLM legge tutto, "scrive" la risposta e spesso si mette pure a spiegarla. Paghi tutto quanto, e poi speri che la risposta sia nel formato che avevi chiesto.
| LLM | Modello decisionale | |
|---|---|---|
| Output | Testo libero | Una risposta tra le opzioni che definisci tu |
| Sa scrivere o ragionare passo passo? | Sì | No |
| Risposta sempre nel tuo formato? | Di solito, non sempre | Sempre |
| Ti dice quanto è sicuro? | Non in modo affidabile | Sì, con una probabilità calibrata |
| Costo | Paghi token di input e di output | Di solito solo l'input, a una frazione del prezzo |
| Velocità | Secondi per le risposte più lunghe | In genere molto meno di un secondo |
| Dà il meglio in | Pianificazione, scrittura, ragionamento aperto | Giudizi rapidi, ripetuti e ben definiti |
Nessuno dei due sostituisce l'altro. Il bello arriva quando li combini, ed è qui che entra in gioco Kahneman.
Pensieri lenti e veloci: Sistema 1 e Sistema 2 per l'IA
Nel suo libro del 2011 Pensieri lenti e veloci, lo psicologo Daniel Kahneman descrive due modalità del pensiero umano:
- Il Sistema 1 è veloce, automatico e senza sforzo. Riconoscere la faccia di un amico, leggere un cartello di stop, sapere che 2 + 2 = 4. Non decidi di farlo: succede e basta.
- Il Sistema 2 è lento, ponderato e faticoso. Organizzare un viaggio, confrontare due offerte di mutuo, calcolare 17 × 24. Richiede attenzione ed energia, quindi lo usi con parsimonia.
L'intuizione chiave è che gran parte di quello che facciamo durante la giornata è Sistema 1. Tiriamo in ballo il Sistema 2 solo quando qualcosa è nuovo, difficile o inaspettato. Se dovessi riflettere consapevolmente su ogni passo mentre cammini, non arriveresti mai da nessuna parte.
Gli agenti IA di oggi hanno solo il Sistema 2
Oggi la maggior parte degli agenti IA usa un modello linguistico di grandi dimensioni per tutto. L'LLM pianifica l'attività e poi lo stesso LLM decide ogni singolo clic, scroll e tasto premuto. È come assumere un analista senior per pianificare un progetto e poi chiedergli di fare di persona anche tutte le fotocopie.
Il risultato è prevedibile: agenti lenti, costosi e che ogni tanto deragliano per una risposta malformata su un passaggio che doveva essere banale.
I modelli decisionali danno all'IA un Sistema 1
Un modello decisionale è il Sistema 1 che mancava: un livello di giudizio veloce, economico e automatico che gestisce le decisioni di routine e sa quando passare la palla.
Metti insieme le due cose e l'architettura assomiglia parecchio alla mente umana:
- Il Sistema 2 (l'LLM) capisce cosa hai chiesto, fa il piano, scrive l'eventuale testo e gestisce tutto ciò che è fuori dall'ordinario.
- Il Sistema 1 (il modello decisionale) prende le tante decisioni rapide e ripetitive necessarie per portare avanti il piano.
- La sicurezza è il segnale per il passaggio di mano. Quando il modello decisionale è sicuro, l'agente agisce. Quando non lo è, la domanda sale all'LLM, proprio come una persona passa al ragionamento attento quando qualcosa non torna.
Perché oggi l'automazione del browser costa cara
Per capire da dove arriva il risparmio, guarda cosa fa davvero un agente IA nel browser a ogni passaggio:
- Legge la pagina. L'agente cattura lo stato della pagina: un DOM semplificato, un albero di accessibilità o uno screenshot.
- Decide. Il modello legge quello stato, insieme all'obiettivo e alla cronologia dei passaggi precedenti, e sceglie l'azione successiva.
- Agisce. L'agente clicca, digita o scorre.
- Verifica. Il modello guarda la nuova pagina per capire se ha funzionato.
Poi si ricomincia. La parte costosa è il passaggio 2. Lo stato della pagina è grande, spesso migliaia di token per passaggio, e molti agenti rimandano a ogni passaggio anche la cronologia dell'attività, che continua a crescere. Secondo le analisi del settore, una tipica attività nel browser in più passaggi richiede da 20.000 a 60.000 token, e in più l'LLM paga i prezzi di output per scrivere ogni azione.
Ma il punto è questo: una volta che la pagina è stata trasformata in un elenco di elementi candidati, la maggior parte di quei passaggi non sono problemi di linguaggio. Sono domande a scelta multipla. "Quale di questi elementi devo cliccare?" "La pagina è cambiata come ci aspettavamo?" Lavoro da Sistema 1, esattamente quello per cui sono fatti i modelli decisionali.
Come i modelli decisionali tagliano fino a 50 volte il costo delle azioni nel browser
Per dare numeri concreti al risparmio, confrontiamo Jev con Claude Haiku 4.5, uno degli LLM più economici di un grande laboratorio di IA. TypeSafe definisce Jev un "System One model" (cioè un "modello Sistema 1"), usando direttamente il termine di Kahneman.
- Jev costa $0.042 per milione di token di input, e l'output è gratis (su OpenRouter). Le risposte arrivano in genere in 70-500 millisecondi.
- Claude Haiku 4.5 costa $1.00 per milione di token di input e $5.00 per milione di token di output.
Prendi un singolo passaggio di routine in un'attività nel browser, come scegliere l'elemento giusto da cliccare.
Con un LLM (Claude Haiku 4.5) per il passaggio: l'agente invia circa 12.000 token di input (istruzioni, definizioni degli strumenti, stato della pagina e cronologia dell'attività) e riceve circa 200 token di output che descrivono l'azione.
- Input: 12.000 × $1.00 / 1M = $0.0120
- Output: 200 × $5.00 / 1M = $0.0010
- Totale: circa $0.013 per passaggio
Con un modello decisionale (Jev) per lo stesso passaggio: non gli servono la cronologia della chat né le definizioni degli strumenti. Riceve l'obiettivo di quel passaggio e gli elementi candidati, circa 6.000 token di input, e restituisce una scelta con il relativo grado di sicurezza. L'output è gratis.
- Input: 6.000 × $0.042 / 1M = $0.00025
- Output: $0
- Totale: circa $0.00025 per passaggio
Parliamo di circa 50 volte meno per ogni passaggio di routine, e in genere la risposta arriva in molto meno di un secondo.
Cosa significa per un'attività completa
Un'attività reale ha comunque bisogno del Sistema 2 da qualche parte: l'LLM deve capire la tua richiesta e pianificarla, e alcuni passaggi saranno davvero ambigui. Quindi il risparmio su un'attività completa dipende soprattutto da una cosa: quanto spesso il modello decisionale rimanda un passaggio all'LLM.
Ecco un'attività da 20 passaggi, con i costi per passaggio visti sopra e una chiamata di pianificazione a Haiku (~$0.0075) nella configurazione ibrida:
| Configurazione | Costo per attività | Costo per 1.000 attività | Risparmio rispetto al solo LLM |
|---|---|---|---|
| LLM (Haiku) per ogni passaggio | $0.260 | $260 | riferimento |
| L'LLM pianifica, il modello decisionale decide, 10% dei passaggi rimandati all'LLM | $0.039 | $39 | ~7 volte meno |
| L'LLM pianifica, il modello decisionale decide, 0% rimandati | $0.013 | $13 | ~20 volte meno |
| Solo modello decisionale, su un flusso di lavoro ripetuto o già pianificato | $0.005 | $5 | ~50 volte meno |
Stime indicative basate sui prezzi di listino pubblici. I numeri reali dipendono dalle dimensioni della pagina, da quanti passaggi richiede un'attività, dal prompt caching e da quanto spesso un'attività ha bisogno dell'LLM.
Lo schema è chiaro: più la tua automazione è fatta di routine, più ti avvicini al 50x. I flussi di lavoro ripetitivi che esegui di continuo, come compilare sempre lo stesso modulo, controllare sempre la stessa dashboard o smistare sempre lo stesso tipo di pagina, sono il terreno dove i modelli decisionali danno il meglio.
Anche i test indipendenti vanno nella stessa direzione. In un test di routing con LiteLLM, 240 chiamate a Jev sono costate $0.0077 contro $0.1985 per le stesse chiamate su Claude Haiku 4.5: circa 26 volte meno.
E pure più veloce
Il costo non è l'unico vantaggio. Un benchmark indipendente ha misurato un tempo di risposta mediano di 239 ms per Jev contro 687 ms per Claude Haiku 4.5, cioè circa 3 volte più veloce. Su un'attività da 20 passaggi sono parecchi secondi in meno passati ad aspettare il browser. Lo stesso benchmark ha registrato zero output malformati dal modello decisionale, visto che può rispondere solo con una delle opzioni che gli sono state date.
I modelli decisionali sono abbastanza precisi?
Risparmiare ha senso solo se i clic sono giusti. Ecco come stanno davvero le cose.
I modelli decisionali danno il meglio con domande ristrette e ben definite. In un benchmark pubblicato sul rilevamento del phishing, fare a Jev un'unica domanda generica ("questa email è phishing?") ha dato il 62,6% di precisione, contro l'81,3% di Haiku. Ma quando lo stesso compito è stato diviso in cinque domande specifiche, il modello decisionale è arrivato al 95,0%, davanti al 93,2% di Haiku.
È di nuovo la lezione del Sistema 1. Il pensiero veloce è bravissimo nei giudizi semplici e specifici, e scarso in quelli complicati e vaghi. Quindi il design giusto divide il lavoro:
- Lascia che l'LLM scomponga l'attività in decisioni piccole e concrete.
- Lascia che il modello decisionale risponda a ogni piccola decisione, come "quale elemento?" o "ha funzionato?".
- Usa la sicurezza come rete di protezione. Le risposte poco sicure tornano all'LLM invece di andare a tentativi.
Le pagine web sono input non affidabili. I ricercatori di sicurezza di Check Point hanno dimostrato che anche i modelli decisionali possono essere bersaglio di prompt injection, proprio come gli LLM. Un insieme fisso di risposte limita i danni (il modello può scegliere solo tra le opzioni che gli ha dato il tuo codice), ma non elimina il rischio. Un motivo in più per cui SurfMind tiene sempre una persona nel giro: le azioni del browser ti chiedono il permesso prima di partire.
I modelli decisionali in SurfMind: pensiero veloce e lento nel tuo browser
Le azioni del browser di SurfMind permettono all'IA di cliccare, scrivere e scorrere al posto tuo, direttamente nelle pagine che stai già usando. Finora ognuno di quei passaggi passava da un modello linguistico.
Stiamo aggiungendo un modello decisionale come Sistema 1 di SurfMind, a partire da Jev:
- L'LLM che scegli tu è il Sistema 2. Capisce la tua richiesta, pianifica l'attività, scrive l'eventuale testo e interviene ogni volta che qualcosa non è chiaro.
- Il modello decisionale è il Sistema 1. Si occupa delle decisioni di routine e ripetitive: trovare l'elemento giusto, confermare che un passaggio è andato a buon fine, individuare pop-up e banner.
- La sicurezza decide il passaggio di mano. Le decisioni sicure vanno avanti. Quelle incerte passano al modello completo, così risparmi senza rinunciare all'affidabilità.
- Il controllo resta tuo. Le azioni del browser ti chiedono comunque il permesso prima di partire.
L'obiettivo è semplice: la stessa automazione del browser che usi oggi, a una frazione del costo, potenzialmente fino a 50 volte meno che far passare ogni passaggio solo da Claude Haiku. È in linea con il modo in cui SurfMind ha sempre funzionato: paghi solo quello che usi e scegli il modello adatto al compito, invece di pagare prezzi premium per tutto.
Vuoi un'IA che lavora nel tuo browser senza farti arrivare una bolletta salata?
SurfMind porta oltre 300 modelli IA e le azioni del browser su ogni pagina che visiti e, con i modelli decisionali, i clic di routine diventano molto più economici.
Post correlati
Vedi tutto
Significato di BYOK: cos'è 'Bring Your Own Key' e perché è il futuro degli strumenti IA
BYOK significa Bring Your Own Key: colleghi la tua chiave API agli strumenti IA invece di pagare abbonamenti. Scopri come risparmiare il 40–90% e iniziare in 5 minuti.
I migliori modelli OpenRouter gratuiti nel 2026 (e come usarli davvero)
OpenRouter ospita modelli gratuiti di NVIDIA, Google, OpenAI e altri. Scopri quali meritano, i limiti effettivi e come usarli nel browser.
5 modi per avere un'IA di qualità Claude/GPT a meno di 5 $ al mese
Dimentica gli abbonamenti da 20 $ al mese. Scopri come accedere a modelli di prima fascia come Claude Sonnet 4.6, GPT-5.4 e Gemini 3 Flash a una frazione del costo, con BYOK e una scelta intelligente dei modelli.